BUSINESS INTELLIGENCE
Le self-service BI augmente la dette analytique quand les métiers créent des rapports, des jeux de données et des calculs plus vite que l'organisation ne peut les maintenir. Chaque contenu sans propriétaire, sans définition partagée et sans date de fin devient un coût de maintenance et de réconciliation. La cause tient à l'absence de cycle de vie des contenus, pas à l'outil.
Trois ans après l'ouverture d'une plateforme de self-service BI, le bilan présenté à la direction est souvent flatteur : plusieurs centaines d'utilisateurs actifs, des milliers de rapports publiés, une file d'attente de l'équipe data enfin résorbée. Ce bilan dit rarement combien de ces rapports sont encore consultés, ni combien calculent le même indicateur de manière différente.
Le self-service BI a souvent été présenté comme la réponse à une dette plus ancienne : celle d'une équipe centrale incapable de traiter les demandes métiers dans des délais raisonnables. L'idée reçue veut qu'en ouvrant la production de chiffres aux métiers, cette dette disparaisse. En réalité, elle change de forme et de place. Les demandes en attente sont remplacées par des contenus en surnombre, dont personne ne connaît l'état.
Cette nouvelle dette a une particularité : elle n'apparaît dans aucun budget. Aucune ligne ne chiffre le temps passé à réconcilier deux versions d'un même chiffre, à chercher le bon rapport ou à comprendre une formule écrite par un collaborateur parti depuis longtemps. Elle se révèle d'un coup, à l'occasion d'une migration d'outil, d'un changement de système source ou d'un comité où deux directions présentent deux valeurs pour le même indicateur.
Le self-service BI ne produit pas cette dette par nature. Il l'augmente dans des conditions précises, qui tiennent à la façon dont la plateforme a été ouverte et à ce que l'organisation choisit de mesurer. Ces conditions se repèrent, la dette qui en résulte se mesure, et elle se réduit sans retirer aux métiers leur accès aux données.
La dette analytique désigne un stock de contenus analytiques dont le coût d'entretien dépasse la valeur qu'ils apportent. Le self-service BI ne l'a pas inventée, mais il en accélère la formation, parce qu'il multiplie le nombre de personnes qui produisent ces contenus.
Tout contenu analytique a un coût après sa création. Un rapport doit être mis à jour quand la source change, vérifié quand un chiffre surprend, expliqué quand un nouveau lecteur le découvre. Un rapport ne coûte pas seulement le temps de sa construction : il coûte chaque mois où il reste en service.
La dette analytique regroupe l'ensemble de ces coûts différés. Elle ne concerne pas un seul type d'objet, mais tout ce qu'une plateforme de BI accumule au fil des usages. Quatre familles de contenus sont concernées :
La notion n'est utile que si elle est distinguée des dettes voisines, avec lesquelles elle est souvent confondue.
Trois notions voisines désignent des stocks de coûts différés. Elles ne portent ni sur les mêmes objets, ni sur les mêmes responsables :
Ces trois dettes s'alimentent mutuellement. Une dette de données non traitée pousse les utilisateurs à corriger localement, dans leurs rapports, les défauts qu'ils rencontrent, ce qui crée de la dette analytique. La dette analytique est la seule des trois que le self-service BI confie en grande partie aux métiers, ce qui explique qu'elle échappe aux dispositifs de suivi pensés pour les équipes techniques.
Dans un modèle centralisé, chaque rapport passait par l'équipe data. Elle en connaissait le nombre, les auteurs et les dépendances. Le self-service BI supprime ce point de passage : les contenus sont créés dans des espaces de travail dispersés, par des personnes qui ne se connaissent pas toujours.
La dette qui en résulte reste invisible pour trois raisons :
La dette analytique ne se voit donc qu'à travers ses effets. Ces effets ont des causes précises, qui tiennent à la manière dont les contenus sont produits.
👉 À lire aussi : Self-service BI : autonomie réelle ou illusion de contrôle ?
La dette analytique ne s'accumule pas au hasard. Elle résulte de mécanismes répétitifs, que l'on retrouve d'une plateforme à l'autre quel que soit l'outil de BI utilisé. Chacun paraît anodin au moment où il se produit.
Quand aucune mesure commune n'est disponible, chaque utilisateur reconstruit l'indicateur dont il a besoin. Le chiffre d'affaires, la marge ou le nombre de clients actifs sont recalculés autant de fois qu'il existe de rapports qui les affichent. Chaque version applique ses propres filtres et ses propres exclusions.
Le coût n'apparaît pas à la création. Il apparaît au premier changement de règle : un nouveau périmètre de filiales, une évolution du plan de comptes, une nouvelle définition du client actif. La modification doit alors être reportée dans chaque rapport, par des personnes qui ignorent souvent que leur calcul est concerné. Les versions non mises à jour continuent d'afficher l'ancienne règle, sans aucun signal pour le lecteur.
Ce mécanisme touche en priorité les chiffres les plus utilisés, puisque ce sont eux qu'on recalcule le plus souvent. Un indicateur clé de performance suivi par toute l'organisation est aussi celui qui existe dans le plus grand nombre de versions concurrentes.
Le même phénomène se produit en amont, dans la préparation des données. Chaque équipe construit son propre jeu de données à partir du système de facturation ou de l'outil de gestion de la relation client, avec ses propres jointures et ses propres nettoyages.
Cette duplication a trois conséquences directes :
Dix jeux de données construits sur la même table source représentent dix points de maintenance pour une seule information.
Un rapport est créé pour répondre à un besoin : préparer une réunion, suivre un lancement, analyser un incident. Le besoin disparaît, le rapport reste. Son auteur change de poste ou quitte l'organisation, et le rapport continue d'exister, accessible et actualisé, sans personne pour en répondre.
Ces rapports orphelins posent deux problèmes distincts. Le premier est un coût direct : ils consomment des ressources et encombrent les espaces de travail. Le second est plus grave : ils restent consultables. Un nouveau collaborateur qui cherche un chiffre peut ouvrir un rapport abandonné depuis un an et le prendre pour une référence.
Les plateformes de self-service BI ne demandent presque jamais de date de fin à la création d'un contenu. La durée de vie par défaut d'un rapport est illimitée, alors que le besoin auquel il répond est souvent temporaire. Ce décalage explique une grande partie du volume de contenus inutilisés sur une plateforme ouverte depuis plusieurs années.
Le self-service BI ne se limite pas à l'outil de BI officiel. Les tableurs connectés aux sources, les extractions retravaillées localement et les fichiers partagés par courriel relèvent des mêmes pratiques. Ces fichiers concentrent souvent les règles de gestion les plus fines, celles que leur auteur a mises au point au fil des années.
Ces règles ne sont écrites nulle part ailleurs. Elles se trouvent dans des formules, des onglets masqués et des corrections manuelles appliquées chaque mois. Le jour où l'auteur du fichier s'absente, la logique de calcul devient illisible pour tous les autres. La dette ne porte plus seulement sur un contenu à maintenir, mais sur un savoir métier qui n'a jamais été transmis.
Pour gagner du temps, de nombreux rapports se connectent directement aux bases des applications métiers plutôt qu'à un entrepôt ou à un modèle partagé. La connexion fonctionne, le rapport est livré, et la dépendance est oubliée.
Cette dépendance ressurgit à la moindre évolution du système source : un champ renommé, une table restructurée, une application remplacée. Les rapports connectés en direct cessent de fonctionner, ou continuent de fonctionner en affichant des valeurs fausses. Les choix d'architecture data pour la BI, l'IA et le self-service conditionnent directement ce risque. Une architecture qui ne propose pas de couche partagée pousse les utilisateurs vers les connexions directes.
Ces cinq mécanismes ont un point commun : aucun ne résulte d'une erreur individuelle, chacun résulte d'une absence de règle au moment de la création. Le volume de contenus qui en découle rejoint un problème déjà bien identifié, celui de la multiplication des tableaux de bord : davantage de chiffres disponibles ne produit pas un meilleur pilotage.
Le même outil de self-service BI peut alourdir ou alléger la dette analytique d'une organisation. La différence tient moins à l'outil qu'aux conditions de son ouverture et aux indicateurs retenus pour juger de son succès.
Le scénario le plus fréquent suit toujours le même ordre : les licences sont déployées, les utilisateurs sont formés à l'outil, les accès aux sources sont ouverts. Le modèle de données partagé est prévu pour une phase ultérieure. Entre-temps, chaque utilisateur construit ses propres préparations de données.
Quand le modèle partagé arrive enfin, il entre en concurrence avec des dizaines de jeux de données déjà en service. Les utilisateurs n'ont aucune raison de reconstruire des rapports qui fonctionnent. Le socle partagé s'ajoute alors à la dette existante au lieu de la remplacer.
L'ordre d'ouverture compte donc autant que le contenu de la plateforme. Les conditions de succès du self-service BI incluent un socle de données préparées disponible dès les premiers usages, et non après.
Beaucoup de programmes de self-service BI suivent leur réussite à travers des indicateurs de volume. Ces indicateurs encouragent précisément ce qui produit la dette :
Un programme évalué sur ces seuls chiffres n'a aucune raison de freiner la croissance de la dette. Tant que la création est comptée et que l'abandon ne l'est pas, la plateforme affiche une réussite qui masque son encombrement.
Le self-service BI peut aussi réduire une dette qui existait avant lui. Avant la plateforme, la même dette analytique existait sous forme de tableurs dispersés, d'extractions envoyées par courriel et de fichiers retraités chaque mois. Une plateforme bien conçue fait entrer ces pratiques dans un environnement où elles deviennent visibles et mesurables.
Cette réduction se produit quand plusieurs conditions sont réunies :
Sans règles, une plateforme de self-service BI accumule de la dette ; avec des règles, elle devient le meilleur outil pour la résorber. La frontière entre les deux situations se situe à un moment précis de la vie de la plateforme.
La dette analytique commence au moment où le rythme de création des contenus dépasse la capacité de l'organisation à les maintenir. Tant que les deux évoluent ensemble, chaque rapport a un responsable et chaque calcul une vérification. Au-delà de ce point, chaque contenu créé sans règle agrandit l'écart entre ce qui existe et ce qui est réellement suivi.
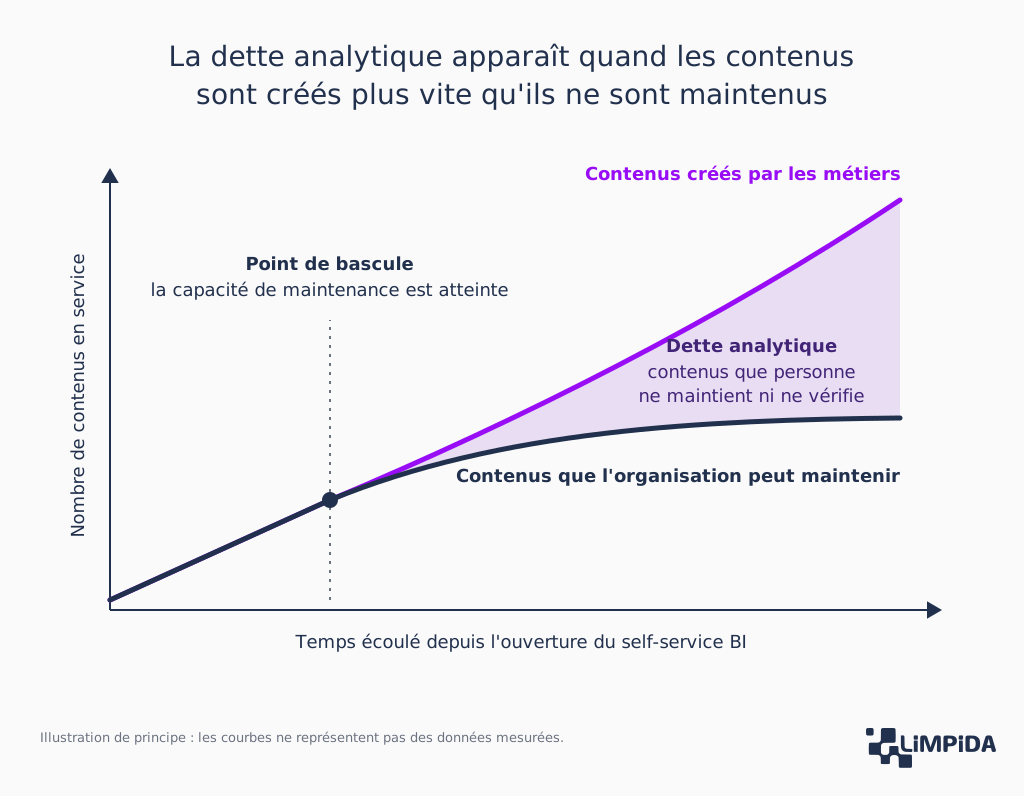
La dette analytique ne se chiffre pas directement en euros. Elle se mesure en revanche par des signaux observables, dans la plateforme et dans le fonctionnement des équipes. Ces signaux suffisent à objectiver le sujet et à décider où agir en premier.
La plupart des outils de BI fournissent des journaux d'usage : qui ouvre quel rapport, à quelle fréquence, depuis quand. Croisés avec l'inventaire des contenus, ces journaux donnent une première image de la dette. D'autres signaux ne figurent pas dans l'outil et demandent d'observer le travail quotidien des équipes data et des métiers.
Chaque forme de dette analytique laisse un signal mesurable et produit un coût précis si rien n'est fait. La lecture croisée de ces signaux permet de repérer la forme de dette la plus coûteuse pour l'organisation.
| Forme de dette | Signal à mesurer | Coût si rien n'est fait |
|---|---|---|
| Indicateurs recalculés | Nombre de définitions différentes d'un même indicateur, relevées dans les rapports qui l'affichent | Chiffres contradictoires en comité, décisions reportées le temps de réconcilier les valeurs |
| Jeux de données dupliqués | Nombre de jeux de données qui interrogent la même table source | Coûts de calcul répétés, anomalies corrigées dans un jeu de données et pas dans les autres |
| Rapports orphelins | Part des rapports non consultés depuis trois mois, part des rapports dont l'auteur n'est plus en poste | Rapport obsolète repris comme référence par un nouveau lecteur, espaces de travail encombrés |
| Calculs dans des fichiers personnels | Nombre de fichiers qui alimentent un indicateur de direction en dehors de la plateforme | Règles de gestion perdues au départ de l'auteur, chiffre impossible à vérifier |
| Connexions directes aux sources | Nombre de rapports connectés directement à une application métier | Rapports interrompus ou faux à chaque évolution du système source |
| Réconciliation permanente | Temps passé par l'équipe data à expliquer des écarts entre deux chiffres | Équipe data occupée à justifier l'existant plutôt qu'à ouvrir de nouveaux usages |
Aucun seuil universel ne permet de dire à partir de quand la dette devient excessive. L'évolution de ces signaux d'un trimestre à l'autre compte davantage que leur valeur absolue.
Un inventaire exhaustif de tous les contenus d'une plateforme est long et décourage vite. Il est plus efficace de partir des chiffres qui comptent, puis de remonter vers les contenus qui les produisent.
Trois points d'entrée donnent rapidement une image utile :
Un inventaire tenu à jour évite de refaire le même travail à chaque migration ou à chaque changement de système source. C'est l'une des raisons de documenter tôt les jeux de données et les indicateurs partagés.
👉 À lire aussi : Qu’est-ce qu’un Data Catalog et pourquoi le mettre en place tôt ?
Une fois la dette mesurée, la tentation consiste à reprendre le contrôle : supprimer massivement, restreindre les droits de publication, recentraliser la production. Cette réaction réduit la dette à court terme et recrée la file d'attente que le self-service BI devait supprimer. Les leviers efficaces agissent sur le cycle de vie des contenus, pas sur l'accès aux données.
Un contenu analytique est créé, sert pendant un temps, puis cesse de servir. Le self-service BI gère très bien la première étape et presque jamais la dernière. Un cycle de vie explicite rend chaque étape visible et attribue une responsabilité à chacune.
Ce cycle repose sur quelques règles simples, appliquées à tous les contenus partagés :
L'archivage par défaut inverse la charge de la preuve : c'est le maintien d'un contenu qui demande une action, et non sa suppression.
Le deuxième levier traite la cause des versions concurrentes. Quand un même calcul apparaît dans plusieurs rapports, il doit être défini une seule fois dans un modèle partagé, puis réutilisé par tous les rapports qui en ont besoin.
Le repérage est simple : les calculs qui reviennent le plus souvent dans l'inventaire sont les premiers candidats. La définition retenue doit être arbitrée par le métier concerné. Un Data Owner tranche entre les versions existantes, puis l'équipe data intègre la version retenue dans le modèle.
Définir une mesure commune sans retirer les versions locales ajoute une version de plus au lieu d'en supprimer. La bascule des rapports existants vers la mesure partagée fait partie du travail, et non d'une étape facultative à traiter plus tard.
La dette analytique d'une plateforme ouverte depuis plusieurs années ne se traite pas en une fois. Elle se traite par vagues successives, dans un ordre qui suit le coût de la dette plutôt que son volume.
Un ordre de traitement efficace suit la portée des chiffres concernés :
Chaque vague produit un résultat visible pour les métiers : moins de chiffres contradictoires, des rapports plus rapides, une recherche plus simple. Ce résultat entretient l'adhésion nécessaire aux vagues suivantes.
Le dernier levier porte sur ce que l'organisation choisit de suivre. Tant que le programme de self-service BI est évalué sur le nombre de rapports créés, la dette reste hors du champ de vision des décideurs.
Quatre indicateurs complètent utilement les indicateurs d'adoption :
Ces indicateurs trouvent leur place dans le suivi régulier de la plateforme, à côté des indicateurs d'usage. Suivre la dette au même niveau que l'adoption évite de présenter comme un succès une croissance qui alourdit la maintenance.
La dette analytique n'est pas le prix inévitable de l'autonomie des métiers. Elle résulte d'un déséquilibre entre ce que la plateforme permet de créer et ce que l'organisation prévoit de maintenir. Les programmes de self-service BI budgètent les licences, la formation et le déploiement. Ils prévoient rarement le temps nécessaire pour entretenir ce qui sera produit.
Cette capacité de maintenance se décide avant l'ouverture d'un nouveau périmètre, pas après la première migration. Elle suppose un propriétaire nommé pour chaque contenu partagé, des mesures communes définies avant l'ouverture des accès, une durée de vie connue de tous pour les contenus sans revue, et une part identifiée du temps de l'équipe data et des référents métiers consacrée à l'entretien de la plateforme.
Aucun de ces éléments ne limite l'autonomie des utilisateurs dans l'exploration ou dans la construction de leurs analyses. Ils limitent uniquement la durée pendant laquelle un contenu peut rester en service sans que personne n'en réponde. Un self-service BI durable se juge moins au nombre de rapports qu'il permet de créer qu'au nombre de rapports dont l'organisation peut répondre.
La dette analytique est l'ensemble des coûts futurs générés par des rapports, des jeux de données et des calculs créés sans règle de maintenance. Elle se forme au moment où la donnée devient un chiffre, et elle s'alourdit à chaque contenu qui reste en service sans que personne n'en réponde.
Les trois notions désignent des coûts différés, mais elles ne portent pas sur les mêmes objets. La dette technique concerne le code et l'infrastructure, la dette de données concerne les données dans les systèmes sources, la dette analytique concerne les contenus construits à partir de ces données.
Le self-service BI augmente la dette analytique quand les contenus sont créés plus vite que l'organisation ne peut les maintenir. Cinq mécanismes reviennent d'une plateforme à l'autre, quel que soit l'outil de BI utilisé.
Oui, à condition que la plateforme soit ouverte avec des règles. Elle fait alors entrer dans un environnement visible et mesurable des pratiques qui existaient déjà sous forme de tableurs et d'extractions dispersés.
La dette analytique se mesure par des signaux observables dans la plateforme et dans le travail des équipes. Les journaux d'usage de l'outil de BI, croisés avec l'inventaire des contenus, en donnent une première image.
Supprimer les rapports inutilisés réduit la dette à court terme, mais ne suffit pas. Sans règles de cycle de vie, les mêmes causes reproduisent le même volume en quelques trimestres.
La responsabilité est partagée entre les métiers qui créent les contenus, les responsables de domaine qui arbitrent les définitions et l'équipe data qui maintient le socle partagé. Elle suppose surtout qu'un temps de maintenance soit prévu et attribué, et non laissé à la bonne volonté de chacun.