IA
Un assistant IA qui interroge directement les tables de l'entreprise doit deviner le sens des colonnes et la formule de chaque indicateur. La couche sémantique lui fournit des définitions validées par les métiers, des règles de calcul imposées et des droits d'accès. Ses réponses deviennent alors cohérentes avec les chiffres officiels et vérifiables.
Poser une question en langage courant et obtenir un chiffre en quelques secondes : c'est la promesse des assistants IA branchés sur les données de l'entreprise. Un directeur régional demande son chiffre d'affaires du trimestre, un responsable logistique le taux de livraisons en retard, sans passer par un tableau de bord ni par l'équipe data.
Les démonstrations sont convaincantes. L'assistant comprend la question, écrit la requête, affiche un chiffre et le commente. La difficulté apparaît quand le chiffre est comparé à celui du reporting officiel, et qu'il ne correspond pas.
L'écart ne vient généralement pas du modèle de langage. Il vient de ce que l'assistant a dû décider seul : quelle table utiliser, quelle colonne de montant, quels filtres appliquer, quelle date retenir. Un assistant IA n'invente pas la donnée, il invente la règle de calcul.
Cette difficulté ne se règle pas en changeant de modèle ou en améliorant la formulation des questions. Elle se règle en donnant à l'assistant ce qui lui manque : la description, validée par les métiers, de ce que signifient les données et de la manière de les calculer.
Un assistant IA connecté à un entrepôt de données dispose de la liste des tables, du nom des colonnes et parfois de quelques commentaires. À partir de ces éléments, il génère une requête qui doit répondre à la question posée. Ce fonctionnement produit plusieurs types d'erreurs, difficiles à repérer pour l'utilisateur.
Les noms de colonnes sont rarement explicites. Une table de ventes peut contenir un montant brut, un montant net, un montant hors taxes et un montant après remises, sous des noms abrégés hérités du logiciel source. L'assistant choisit celui qui lui semble correspondre à la question.
Ce choix repose sur des indices fragiles : la ressemblance entre le nom de la colonne et les mots de la question, ou les métadonnées disponibles quand elles existent. Une colonne mal nommée ou mal documentée suffit à fausser la réponse.
Même quand il choisit la bonne colonne, l'assistant doit encore reconstituer la règle de calcul. Plusieurs décisions lui reviennent alors, et chacune peut produire un écart avec le chiffre officiel :
Chacune de ces décisions a été tranchée un jour par les métiers, puis inscrite dans les rapports officiels. L'assistant n'a pas accès à ces arbitrages s'ils ne sont écrits nulle part de façon exploitable.
Le problème le plus sérieux tient à la forme des réponses. Un assistant IA formule son résultat avec assurance, accompagné d'un commentaire cohérent. Rien n'indique à l'utilisateur que le chiffre a été calculé avec une règle différente de celle du reporting.
Ces erreurs ne relèvent pas seulement de la qualité des données. Des données parfaitement propres produisent quand même des chiffres faux si la règle de calcul est mal reconstituée. La mauvaise qualité des données reste un risque majeur pour l'IA, mais la sémantique en est un autre, distinct et tout aussi concret.
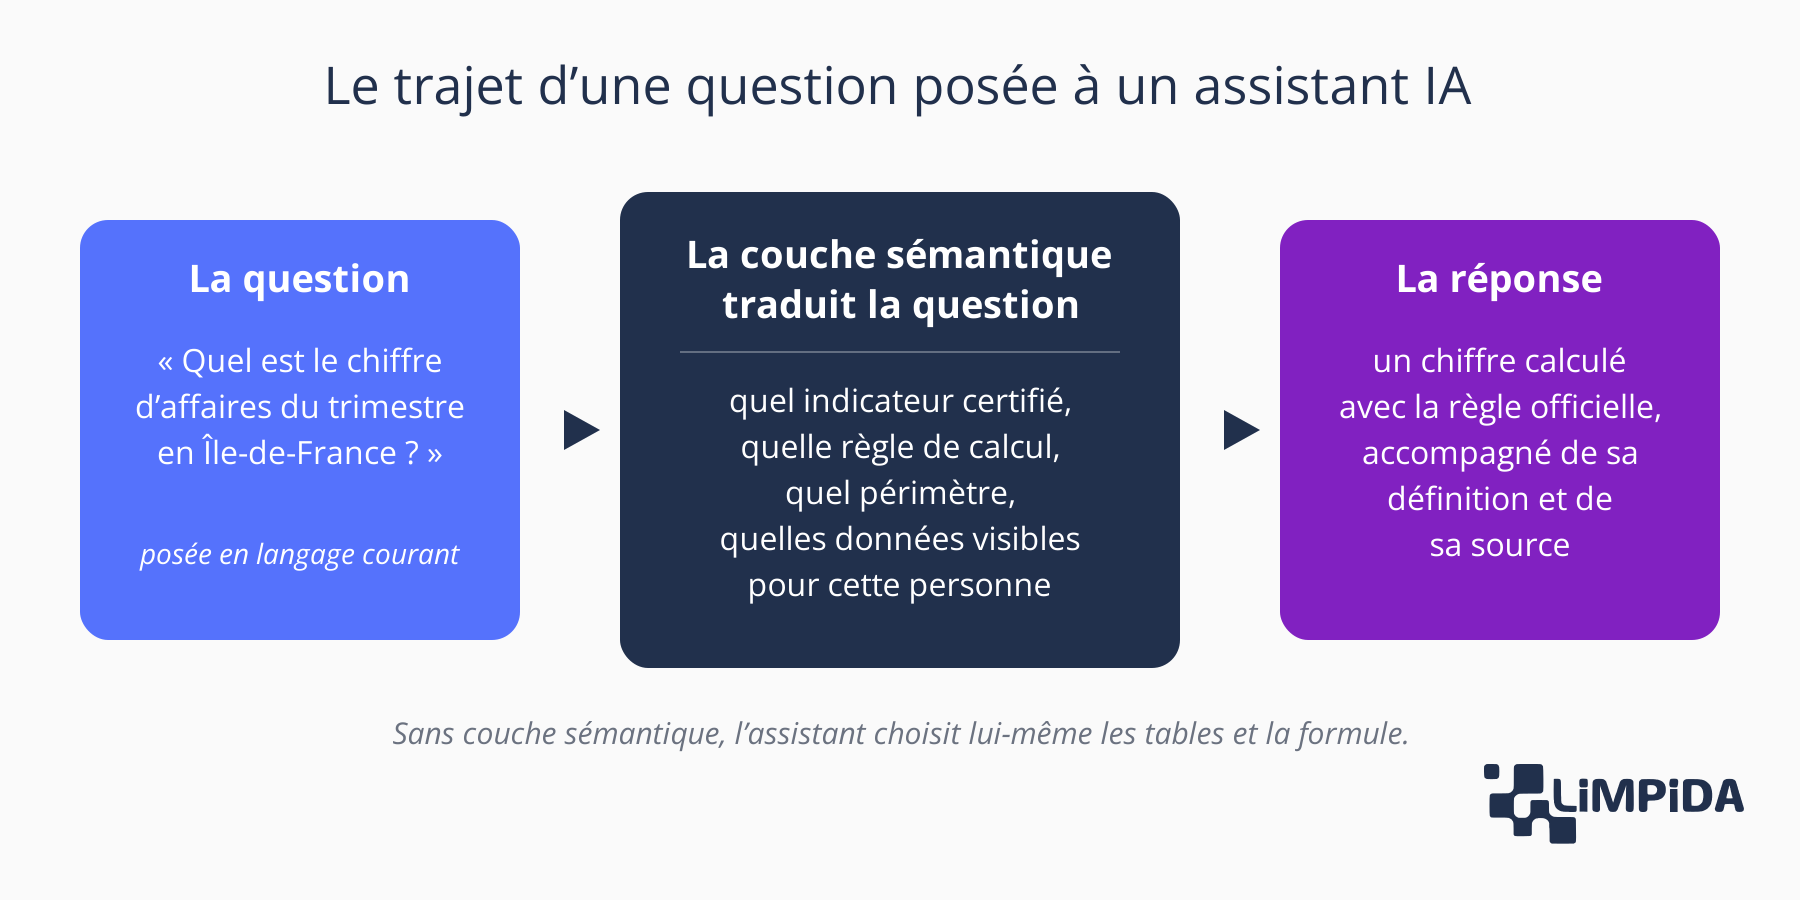
La couche sémantique décrit les indicateurs, les axes d'analyse et les règles de calcul dans les termes du métier. Pour un assistant IA, elle change la nature de la tâche : au lieu de construire une requête à partir des tables, il choisit un indicateur défini et un axe d'analyse.
Chaque indicateur de la couche porte un nom métier et une description en français. L'assistant compare la question à ces descriptions, et non à des noms de colonnes techniques. Le choix du bon indicateur devient beaucoup plus fiable.
Les descriptions peuvent aussi préciser les synonymes utilisés par les métiers. Le chiffre d'affaires, les ventes, le CA ou le revenu renvoient au même indicateur, et l'assistant le sait parce que la couche le lui indique.
Quand l'assistant interroge un indicateur de la couche, il n'écrit pas la formule. La couche applique la règle validée par les métiers : les mêmes exclusions, la même date de référence, le même périmètre que dans le reporting officiel. L'assistant obtient le chiffre officiel parce qu'il ne peut pas en calculer un autre.
Un assistant IA est interrogé par des collaborateurs qui n'ont pas tous les mêmes droits. Un commercial ne doit voir que les clients de son secteur, un responsable de filiale que les chiffres de sa filiale.
Si les droits sont portés par la couche sémantique, ils s'appliquent automatiquement aux réponses de l'assistant, comme ils s'appliquent dans l'outil de BI. La question de la sécurité des données ne repose plus sur le paramétrage propre à chaque outil.
Une réponse issue de la couche sémantique peut être accompagnée de sa définition : le nom de l'indicateur utilisé, sa règle de calcul, les filtres appliqués et la date des données. L'utilisateur sait ce qu'il lit, et l'équipe data peut retrouver l'origine d'un chiffre contesté, avec l'aide du lignage des données pour remonter jusqu'aux sources.
Le schéma suivant résume le trajet d'une question posée à un assistant IA qui s'appuie sur une couche sémantique.
Le tableau ci-dessous compare, pour quelques questions courantes, le comportement d'un assistant qui interroge les tables et celui d'un assistant qui interroge la couche sémantique.
| Question posée | Assistant qui interroge les tables | Assistant qui interroge la couche sémantique |
|---|---|---|
| Quel est le chiffre d'affaires du trimestre ? | choisit une colonne de montant et une date parmi plusieurs possibles | applique la règle officielle du chiffre d'affaires net |
| Combien de clients actifs avons-nous ? | invente une définition de client actif à partir des tables disponibles | utilise la définition validée et indique laquelle |
| Quelles sont les ventes de ma région ? | peut renvoyer des données hors du périmètre de l'utilisateur | filtre automatiquement selon les droits de l'utilisateur |
| Pourquoi la marge baisse-t-elle ? | compare des chiffres calculés avec des règles qui varient d'une requête à l'autre | compare des chiffres calculés avec la même règle |
Le sujet a pris une place importante dans les travaux des analystes en 2026. Gartner a placé la sémantique parmi les trois grands thèmes de ses tendances sur la donnée et l'analytique pour l'année, aux côtés des agents IA et de la convergence des plateformes.
En mai 2026, lors de son sommet Data & Analytics de Londres, le cabinet a estimé que négliger la sémantique rend les agents IA inexacts et inefficaces, avec des dépenses gaspillées et des fragilités accrues en matière de gouvernance. Il a avancé que les organisations qui donnent la priorité à la sémantique dans la préparation de leurs données pour l'IA devraient, d'ici 2027, améliorer la précision de leurs agents IA jusqu'à 80 % et réduire leurs coûts jusqu'à 60 %.
Gartner considère également que les modèles de données classiques, fondés sur les seuls schémas de tables, ne suffisent plus aux agents IA, parce qu'ils ne contiennent ni le contexte métier ni le sens des données. Sa recommandation est de faire de cette couche de contexte un composant central de l'architecture data.
La couche sémantique améliore nettement la fiabilité des réponses chiffrées. Elle ne règle pas pour autant tous les problèmes d'un assistant IA branché sur les données, et il faut connaître ses limites avant de la présenter comme une garantie.
La couche applique la bonne règle de calcul aux données disponibles. Si les données sources contiennent des doublons, des valeurs manquantes ou des erreurs de saisie, le chiffre sera calculé correctement sur des données fausses. La couche sémantique et le travail sur la qualité des données répondent à deux problèmes différents, et l'un ne remplace pas l'autre.
Un assistant ne peut s'appuyer que sur les indicateurs décrits dans la couche. Si un utilisateur pose une question qui ne correspond à aucun indicateur, deux comportements sont possibles : l'assistant indique qu'il ne peut pas répondre, ou il revient aux tables et recalcule à sa façon.
Le second comportement réintroduit exactement le risque que la couche devait supprimer. Le choix entre les deux est une décision de gouvernance, à prendre explicitement avant le déploiement.
Certaines questions peuvent correspondre à plusieurs indicateurs de la couche. Une demande sur les ventes du mois peut viser le chiffre d'affaires facturé, le montant des commandes prises ou le volume livré. La couche sémantique propose ces indicateurs, mais elle ne choisit pas à la place de l'utilisateur.
Un assistant bien configuré demande alors une précision, ou indique l'indicateur qu'il a retenu en rappelant sa définition. Cette règle de comportement se paramètre au moment du déploiement, et elle se vérifie lors des tests. Un assistant qui choisit en silence entre deux indicateurs reproduit, à une échelle plus réduite, le problème de la règle de calcul implicite.
La couche sémantique porte sur les données structurées : les tables, les indicateurs, les axes d'analyse. Les questions qui portent sur des contrats, des procédures ou des comptes rendus relèvent d'autres approches, fondées sur la recherche dans les documents. Un même assistant peut combiner les deux, à condition que chaque type de réponse indique sa source.
Une couche sémantique conçue pour un outil de BI n'est pas toujours prête à servir un assistant IA. Les utilisateurs d'un outil de BI choisissent un indicateur dans une liste. Un assistant doit le retrouver à partir d'une question formulée librement, ce qui demande un travail complémentaire.
Chaque indicateur et chaque axe d'analyse reçoit une description rédigée en français courant, qui indique ce qu'il mesure, ce qu'il exclut et dans quels cas l'utiliser. Plusieurs éléments rendent ces descriptions réellement utiles à un assistant :
Ces descriptions relèvent du travail des métiers autant que de celui de l'équipe data. Ce sont les utilisateurs qui connaissent les mots qu'ils emploient et les questions qu'ils se posent.
Toutes les définitions de la couche n'ont pas le même statut. Certaines ont été validées par leur propriétaire métier, d'autres sont en cours de discussion ou réservées à un usage exploratoire. Un assistant ouvert à tous les collaborateurs ne devrait s'appuyer que sur les indicateurs certifiés.
Cette restriction réduit le périmètre des questions auxquelles l'assistant peut répondre. Elle garantit en revanche que chaque chiffre fourni peut être défendu en réunion.
Avant le déploiement, l'assistant est confronté à une série de questions réelles, collectées auprès des métiers. Pour chacune, la réponse attendue est connue, ce qui permet de mesurer l'écart.
Ce jeu de questions de test se construit à partir de plusieurs sources, pour couvrir des formulations variées :
Les réponses attendues aux questions de test ne sont pas fixées par l'équipe data seule. Chaque propriétaire d'indicateur valide les réponses qui concernent son périmètre, et confirme que l'assistant utilise la bonne définition.
Cette implication a un second avantage. Les propriétaires découvrent les questions que les collaborateurs posent réellement, et repèrent les indicateurs dont la description doit être précisée. La recette de l'assistant devient aussi une revue des définitions de la couche.
Une fois l'assistant en service, les questions auxquelles il ne sait pas répondre sont une information précieuse. Elles indiquent les indicateurs qui manquent dans la couche, les synonymes qui ne sont pas reconnus et les besoins métier qui n'avaient pas été identifiés.
Le suivi de ces questions alimente l'évolution de la couche. Il s'inscrit dans le pilotage plus large des usages de l'IA, au même titre que l'inventaire des systèmes d'IA déployés dans l'entreprise.
Les assistants IA rendent l'accès aux données beaucoup plus simple. Ils rendent aussi beaucoup plus visible l'absence de définitions partagées, parce qu'ils répondent à tout le monde, sur tous les sujets, sans passer par l'équipe qui connaissait les règles.
La couche sémantique ne rend pas l'assistant plus intelligent. Elle lui donne accès aux décisions déjà prises par l'organisation sur la manière de calculer ses chiffres. Pour un projet d'IA sur les données, c'est souvent le travail qui détermine si les réponses seront utilisées en réunion ou vérifiées systématiquement dans les tableaux de bord.
Ce travail s'inscrit dans la gouvernance de l'IA, qui fixe les règles d'usage et les responsabilités. La méthode pour gouverner l'IA en entreprise s'applique ici directement : un assistant qui répond sur les chiffres de l'entreprise a besoin d'un responsable, d'un périmètre et d'un suivi.
Un assistant IA qui interroge directement les tables doit choisir seul les colonnes, les filtres et la formule de calcul. Ses choix diffèrent souvent des règles appliquées dans le reporting officiel, même quand les données sont justes.
La couche sémantique fournit à l'assistant des indicateurs définis par les métiers, avec leur règle de calcul et leurs droits d'accès. Il choisit un indicateur au lieu de reconstruire une formule, et obtient donc le chiffre officiel.
Non. La couche sémantique garantit que les chiffres sont calculés avec la bonne règle, mais elle ne corrige pas les données sources et ne couvre que les indicateurs qu'elle décrit.
Gartner a placé la sémantique parmi ses trois grandes tendances sur la donnée et l'analytique pour 2026. En mai 2026, le cabinet a estimé que négliger la sémantique rend les agents IA inexacts et plus coûteux.
Une couche conçue pour un outil de BI demande un travail complémentaire pour servir un assistant IA, qui doit retrouver le bon indicateur à partir d'une question formulée librement.
Deux comportements sont possibles : refuser de répondre, ou interroger directement les tables. Le choix est une décision de gouvernance, à prendre avant le déploiement.
Non. La couche sémantique porte sur les données structurées : tables, indicateurs et axes d'analyse. Les questions sur des contrats, des procédures ou des comptes rendus relèvent de la recherche dans les documents.