DATA GOVERNANCE
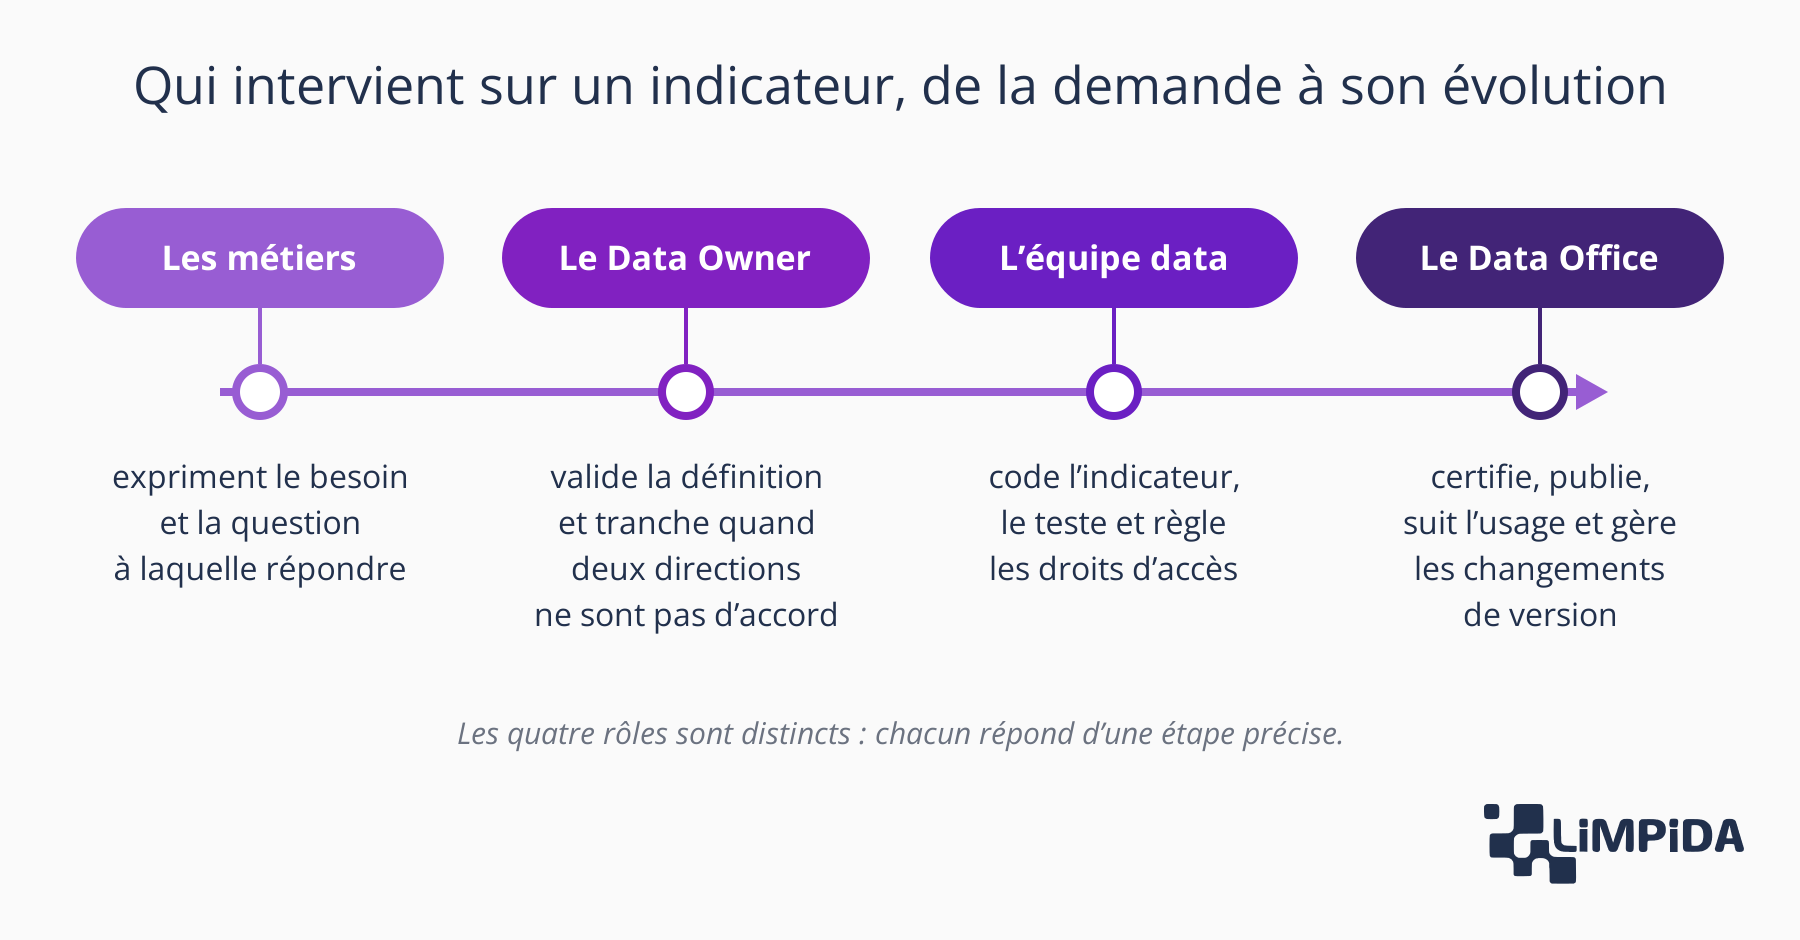
Une couche sémantique ne peut pas être portée par un seul acteur. Les métiers définissent ce que mesure chaque indicateur, le Data Owner valide la règle et tranche les désaccords, l'équipe data l'implémente et en garantit la performance, et le Data Office certifie les indicateurs et organise leur évolution. Sans cette répartition, la couche se dégrade rapidement.
La question de la responsabilité arrive souvent après coup. La couche sémantique a été mise en place par l'équipe data, les premiers indicateurs fonctionnent, les outils de BI s'y raccordent. Puis une direction demande à modifier le calcul de la marge, une autre s'y oppose, et personne ne sait qui doit trancher.
Dans beaucoup d'organisations, la réponse par défaut consiste à confier la couche à l'équipe technique qui l'a construite. Elle connaît l'outil, elle maîtrise le code, elle reçoit déjà les demandes. Ce choix paraît naturel, mais il revient à demander à des développeurs d'arbitrer des définitions métier.
La réponse inverse, qui consiste à confier la couche aux métiers, ne fonctionne pas mieux. Les directions savent ce qu'elles veulent mesurer, mais elles n'ont ni les compétences ni le temps pour maintenir un composant logiciel. Une couche sémantique se situe exactement entre ce que les métiers décident et ce que l'équipe data implémente.
Sa responsabilité doit donc être partagée, avec une répartition claire de ce qui revient à chacun. C'est cette répartition qui détermine si la couche restera cohérente dans la durée.
Une couche sémantique n'est pas un outil comme les autres. Elle contient à la fois du code, exécuté par une plateforme technique, et des décisions métier, qui engagent la manière dont l'entreprise mesure sa performance. Cette double nature explique la difficulté à lui trouver un responsable unique.
Chaque indicateur de la couche sémantique combine deux éléments. Le premier est une définition : ce que mesure l'indicateur, ce qu'il exclut, à quelle question il répond. Le second est une implémentation : la requête, les jointures, les filtres, les performances.
Ces deux éléments n'appellent pas les mêmes compétences. La définition relève de ceux qui utilisent l'indicateur pour décider. L'implémentation relève de ceux qui connaissent les données et la plateforme. Confier les deux à la même équipe conduit presque toujours à négliger l'un des deux.
Les indicateurs les plus utiles dans une couche sémantique sont ceux que plusieurs directions utilisent. Ce sont aussi ceux dont la propriété est la plus difficile à attribuer. Le chiffre d'affaires intéresse la finance, la direction commerciale et le marketing, et chacune a de bonnes raisons de vouloir en fixer la règle.
Ce type de situation ne se résout pas techniquement. Il demande une instance capable de trancher, et une règle qui précise qui en a l'autorité.
La répartition la plus solide distingue quatre rôles, qui interviennent à des moments différents de la vie d'un indicateur. Chaque rôle a un périmètre précis, et aucun ne peut être tenu à la place d'un autre sans dégrader le résultat.
Les directions métier sont à l'origine des indicateurs. Elles savent quelles décisions elles prennent et quelles informations leur manquent. Leur rôle consiste à formuler le besoin en termes de questions, plutôt qu'en termes de calculs.
Plusieurs contributions sont attendues des métiers, à chaque nouvelle demande d'indicateur :
Le Data Owner du domaine concerné valide la définition de l'indicateur et chacune de ses modifications. Quand plusieurs directions utilisent un même indicateur, c'est lui qui arbitre, ou qui porte le désaccord devant l'instance de gouvernance des données si l'arbitrage dépasse son périmètre.
Pour les indicateurs transverses, la désignation du propriétaire mérite une attention particulière. Le chiffre d'affaires relève souvent de la direction financière, parce qu'elle en publie la version officielle. D'autres indicateurs, comme la satisfaction client, peuvent relever d'une direction opérationnelle.
L'équipe data, rattachée à la DSI ou au Data Office selon les organisations, traduit la définition validée en code. Elle choisit les tables sources, écrit les règles de calcul, configure les droits d'accès et garantit les performances des requêtes.
Les Data Engineers et les développeurs de la couche ont aussi un rôle d'alerte. Quand une définition est ambiguë ou impossible à calculer avec les données disponibles, ils le signalent au propriétaire plutôt que d'interpréter eux-mêmes.
Le Data Office organise le fonctionnement d'ensemble. Il tient la liste des indicateurs, attribue leur statut, publie les définitions et suit l'usage de la couche. C'est aussi lui qui gère les évolutions dans le temps : nouvelles versions, indicateurs retirés, communication aux utilisateurs.
Le schéma suivant présente l'enchaînement de ces quatre rôles, de la demande initiale à la vie de l'indicateur dans la couche.
👉 À lire aussi : Data Owner, Data Steward, Data Custodian : le triptyque pour réussir sa gouvernance des données
La répartition des rôles s'inscrit dans l'organisation existante. Selon la place du Data Office et la maturité des directions, trois modèles se rencontrent. Aucun n'est meilleur dans l'absolu : chacun convient à une situation donnée.
Dans ce modèle, la DSI héberge la couche sémantique, l'implémente et en assure l'exploitation. Les définitions sont validées par les métiers, mais la DSI pilote le circuit des demandes. Ce modèle convient aux organisations sans Data Office constitué, où la DSI concentre les compétences data.
Son risque principal tient à la priorisation. Les demandes d'indicateurs entrent en concurrence avec les autres projets informatiques, et les délais s'allongent. Les métiers finissent alors par recréer leurs calculs dans leurs propres outils.
Dans ce modèle, le Data Office est responsable de la couche dans son ensemble : il organise le circuit des définitions, certifie les indicateurs et s'appuie sur une équipe data qui lui est rattachée ou qui travaille pour lui. Le Chief Data Officer en rend compte au comité de direction.
Ce modèle est le plus cohérent quand un Data Office existe et dispose d'une légitimité reconnue par les directions. Le rôle du Data Office dans la gouvernance des données s'étend alors naturellement à la couche sémantique.
Dans les organisations les plus décentralisées, chaque domaine métier gère ses propres indicateurs dans la couche, avec ses propres ressources data. Un ensemble commun de règles et d'indicateurs transverses reste porté par une équipe centrale.
Ce modèle donne de l'autonomie aux domaines et accélère les évolutions. Il suppose en revanche des règles communes solides (conventions de nommage, statuts, circuit de certification) et une instance capable d'arbitrer les indicateurs partagés entre domaines.
Le tableau suivant résume les trois modèles et les conditions dans lesquelles chacun fonctionne.
| Modèle | Qui pilote | Situation adaptée | Risque principal |
|---|---|---|---|
| Porté par la DSI | la DSI héberge, implémente et gère les demandes | pas de Data Office constitué, compétences data concentrées à la DSI | délais liés à la concurrence avec les autres projets informatiques |
| Porté par le Data Office | le Data Office certifie et organise, l'équipe data implémente | Data Office reconnu par les directions | dépendance à la capacité de l'équipe centrale |
| Réparti par domaine | chaque domaine gère ses indicateurs, une équipe centrale fixe les règles | domaines dotés de ressources data et habitués à travailler ensemble | divergences entre domaines sur les indicateurs partagés |
Une couche sémantique en service génère des décisions régulières. Les organisations qui les anticipent évitent les blocages. Celles qui les découvrent au fil de l'eau voient les demandes s'accumuler sans réponse.
Le premier arbitrage concerne les indicateurs partagés. Quand deux directions ne s'accordent pas sur une règle, plusieurs issues sont possibles, et le circuit doit préciser qui choisit entre elles :
Le travail mené sur un référentiel d'indicateurs permet souvent de régler ces désaccords en amont, avant que les définitions ne soient implémentées.
Le deuxième arbitrage porte sur les modifications. Changer la règle de calcul d'un indicateur modifie les chiffres publiés, parfois sur plusieurs années d'historique. Les utilisateurs doivent savoir pourquoi leurs tableaux de bord affichent soudain des valeurs différentes.
Plusieurs décisions accompagnent chaque modification : faut-il recalculer l'historique ou garder l'ancienne règle pour les périodes passées ? Faut-il conserver l'ancienne version de l'indicateur pendant une période de transition ? Ces questions relèvent du propriétaire et du Data Office, et leurs réponses sont tracées grâce au versioning des données et des définitions.
Le troisième arbitrage est souvent oublié. Une couche sémantique accumule des indicateurs au fil des demandes, et une partie d'entre eux cesse d'être utilisée. Les conserver alourdit la couche, complique le travail des assistants IA et entretient la confusion.
La répartition des rôles se met en place plus facilement au lancement de la couche sémantique qu'une fois celle-ci en service. Au démarrage, les indicateurs sont peu nombreux, les habitudes ne sont pas encore prises et les directions sont attentives au projet.
Chaque indicateur du premier lot reçoit un propriétaire nommé avant que l'équipe data ne commence l'implémentation. Ce propriétaire valide la fiche de définition, assiste à la recette et signe la certification.
Cette règle a un effet immédiat sur le périmètre. Un indicateur pour lequel aucun propriétaire n'accepte de s'engager n'entre pas dans le premier lot. Le premier lot se limite aux indicateurs qui ont un responsable, et non à ceux qui semblent les plus importants.
Le circuit d'une demande d'indicateur ou de modification tient en une page, partagée avec toutes les directions. Il précise les étapes, les personnes concernées et les délais attendus.
Une page suffit à condition de couvrir les points qui posent habituellement problème :
Le rôle de propriétaire d'indicateur prend du temps, surtout au lancement : relire les fiches, participer aux ateliers, valider les résultats, arbitrer les premiers désaccords. Ce temps doit être reconnu par la direction du propriétaire, faute de quoi les validations prennent du retard.
Après le premier lot, la charge diminue. Elle se limite alors aux demandes de modification et aux revues périodiques, que le Data Office peut regrouper pour limiter les sollicitations.
La répartition initiale repose sur des hypothèses : le volume de demandes, la disponibilité des propriétaires, la capacité de l'équipe data. Quelques mois après le lancement, un bilan permet de vérifier qu'elle fonctionne.
Ce bilan s'appuie sur des constats simples : le délai moyen de traitement d'une demande, le nombre de chiffres contestés, la part des rapports de direction raccordés à la couche. Si les délais s'allongent ou si les contestations se multiplient, la répartition des rôles est ajustée avant que les métiers ne se détournent de la couche.
Une répartition des rôles peut exister sur le papier sans fonctionner dans les faits. Plusieurs signaux permettent de repérer qu'une couche sémantique manque d'un responsable réel, avant que la situation ne devienne difficile à corriger :
Ces signaux ne relèvent pas de la technique. Ils indiquent que les rôles décrits dans les règles de gouvernance ne sont pas tenus. Une couche sémantique sans responsable reproduit, avec un outil de plus, les incohérences qu'elle devait supprimer.
La question du porteur n'a donc pas une réponse unique. Elle a une réponse par rôle : les métiers expriment, le Data Owner tranche, l'équipe data implémente, le Data Office certifie. Le modèle d'organisation choisi détermine qui emploie l'équipe data et qui pilote le circuit, mais la répartition des rôles reste la même.
La responsabilité d'une couche sémantique est partagée entre quatre rôles. Les métiers expriment le besoin, le Data Owner valide la définition, l'équipe data implémente l'indicateur et le Data Office certifie et organise l'évolution de la couche.
La DSI peut héberger, implémenter et exploiter la couche sémantique, notamment quand il n'existe pas de Data Office. Elle ne peut pas, en revanche, valider seule les définitions des indicateurs, qui relèvent des métiers.
Le Data Office organise le fonctionnement d'ensemble de la couche sémantique. Il tient la liste des indicateurs, attribue leur statut, publie les définitions et gère les évolutions dans le temps.
Le Data Owner de l'indicateur arbitre en premier lieu. Si le désaccord dépasse son périmètre, il le porte devant l'instance de gouvernance des données, qui tranche en dernier recours.
Certifier un indicateur signifie attester que sa définition a été validée par son propriétaire, que son implémentation a été testée et que ses résultats ont été rapprochés des chiffres de référence.
Une modification de règle change les chiffres publiés, parfois sur plusieurs années d'historique. Elle doit être validée par le propriétaire de l'indicateur, tracée et annoncée aux utilisateurs.
Plusieurs signaux indiquent qu'une couche sémantique n'a pas de responsable réel, même si les rôles existent sur le papier.