ARCHITECTURE
Une architecture hybride se justifie pour trois catégories de données : celles qu'une contrainte réglementaire ou contractuelle oblige à garder sous contrôle direct, celles que des systèmes industriels ou opérationnels exploitent en temps réel, et celles d'applications stables sans version cloud satisfaisante. Chaque maintien sur site doit être décidé par écrit, avec un responsable et une date de révision.
Une migration vers le cloud se termine rarement avec la totalité des données dans le cloud. Après les premières vagues, une partie des systèmes tourne toujours dans le centre de données de l'entreprise : une base de production d'usine, une application de gestion ancienne, un entrepôt de données dont personne n'a tranché le sort. Ces systèmes restants sont-ils sur site pour de bonnes raisons ? Dans beaucoup d'organisations, personne n'est capable de répondre précisément.
Deux lectures opposées de cette situation circulent dans les DSI. La première voit dans l'hybride un aveu d'échec, la preuve que la migration n'a pas été menée à son terme. La seconde en fait une cible par défaut, présentée comme prudente parce qu'elle évite de trancher. Ces deux lectures ont le même défaut : elles jugent l'architecture hybride en bloc, alors que sa pertinence se décide système par système.
Une même architecture, avec une partie des données sur site et une autre dans le cloud, peut être un choix solide ou une dérive coûteuse. La différence ne se voit pas sur un schéma d'infrastructure, elle se voit dans les raisons écrites qui justifient chaque système maintenu. Un hybride choisi repose sur des critères explicites et une date de révision. Un hybride subi repose sur une migration interrompue, des flux bricolés et des coûts qui s'additionnent sans que personne ne les pilote.
Les organisations qui tirent parti d'une architecture hybride des données ont un point commun : elles savent dire, pour chaque système resté sur site, quelle contrainte le retient, quelle version de la donnée fait foi et à quelle date la décision sera réexaminée. Les organisations qui subissent l'hybride découvrent ces questions plus tard, au moment où une facture, un incident ou un audit les impose.
L'architecture hybride des données désigne une organisation où une partie des données et des traitements reste sur une infrastructure gérée par l'entreprise, pendant qu'une autre partie fonctionne chez un ou plusieurs fournisseurs de cloud. Les deux environnements sont reliés par des flux qui permettent aux usages de consommer des données issues des deux côtés.
Cette définition couvre des configurations très différentes. Une usine qui garde ses systèmes de supervision sur site et envoie chaque nuit des indicateurs agrégés vers une plateforme analytique cloud est en architecture hybride. Une banque qui conserve son système central de tenue de comptes dans ses propres centres de données et exploite ses données marketing dans le cloud l'est aussi. Une entreprise qui a migré la moitié de son entrepôt de données avant que le projet ne s'arrête l'est également, mais pour de tout autres raisons.
L'hybride choisi résulte d'une décision. Pour chaque système maintenu sur site, une raison est identifiée : une obligation réglementaire, une contrainte de latence, un coût de migration disproportionné par rapport au bénéfice attendu. Cette raison est écrite, partagée avec les métiers et revue à intervalles réguliers. Les flux entre les deux environnements sont conçus, documentés et surveillés.
L'hybride subi résulte d'une absence de décision. La migration a commencé, puis le budget a été réalloué, l'équipe projet a changé ou une difficulté technique a bloqué la suite. Les systèmes restés sur site ne le sont pour aucune raison particulière, sinon que personne n'a pris le temps de les migrer ni de les arrêter. Un hybride subi coûte presque toujours plus cher que chacun des deux environnements pris isolément. Les équipes exploitent deux infrastructures, maintiennent deux jeux de compétences et réconcilient des données qui divergent.
La distinction n'a rien de théorique. Elle conditionne la manière d'aborder chaque système resté sur site : un système maintenu pour une raison valable doit être correctement intégré à l'architecture, alors qu'un système maintenu par inertie doit être réexaminé.
Un plan de migration qui vise le tout cloud par principe produit souvent des arbitrages forcés : des systèmes industriels déplacés au prix d'une dégradation des temps de réponse, des applications réécrites sans bénéfice pour les métiers, des données sensibles exposées à des exigences contractuelles mal évaluées. À l'inverse, un plan qui accepte dès le départ une part d'hybride peut concentrer l'effort sur les systèmes où la migration crée réellement de la valeur.
Le cadrage d'ensemble de la migration, avec la liste des décisions possibles pour chaque système, est développé dans l'article Migrer ses données vers le cloud : par quoi commencer et que laisser en place ? Pour les systèmes candidats au maintien sur site, la décision mérite d'être instruite critère par critère, avec la même rigueur qu'une décision de migrer.
La décision de garder des données sur site repose sur un petit nombre de critères, qui doivent être examinés pour chaque système et non pour l'ensemble du système d'information. Un même domaine de données peut d'ailleurs relever de critères différents selon les traitements : la donnée brute d'un capteur et l'indicateur mensuel qui en découle n'ont pas les mêmes contraintes.
Les contraintes réglementaires sont souvent citées en premier pour justifier le maintien sur site, et souvent de manière imprécise. Les principaux textes applicables en France n'interdisent pas le cloud. Ils encadrent le choix de l'hébergeur, le lieu de stockage ou les transferts de données, ce qui est très différent.
Trois cadres reviennent régulièrement dans les arbitrages d'une architecture hybride :
À ces textes s'ajoutent les exigences contractuelles : clauses de clients industriels sur la localisation de leurs plans, engagements de confidentialité, politiques internes de sécurité. Ces exigences sont parfois plus restrictives que la réglementation elle-même. Une contrainte de souveraineté des données doit être sourcée : un texte, un contrat ou une politique interne identifiés, et non une impression partagée. La question doit être instruite avec le délégué à la protection des données et le responsable de la sécurité, dès le cadrage. L'article Quelles normes s'appliquent réellement à un projet Data ou IA ? aide à faire le tri entre les obligations réelles et les exigences supposées.
Certains traitements doivent s'exécuter au plus près des équipements qui produisent ou consomment la donnée. Un système de supervision de ligne de production, un automate qui ajuste un réglage à partir de mesures en continu ou un logiciel de gestion d'entrepôt qui pilote des convoyeurs ne peuvent pas dépendre d'un aller-retour vers un centre de données distant. Une coupure du lien réseau ne doit pas arrêter l'atelier.
Pour ces traitements, le maintien sur site est une exigence d'exploitation. Il ne concerne pas pour autant toutes les données produites. Les mesures brutes servent localement au pilotage en temps réel, alors que leurs agrégats (rendement par équipe, taux d'arrêt, consommation par produit) alimentent des analyses qui n'ont pas besoin de la même réactivité. La bonne question porte sur le délai réellement exigé par chaque usage, pas sur la nature industrielle de la donnée. L'article Temps réel, quasi temps réel, batch : comment choisir sans sur-architecturer ? détaille comment qualifier ces besoins de fraîcheur.
Une partie des applications métier n'a pas d'équivalent cloud satisfaisant. L'éditeur ne propose pas d'offre hébergée, ou son offre impose une montée de version lourde, ou les adaptations spécifiques accumulées au fil des années rendent la reprise très coûteuse. Un ERP fortement personnalisé, un logiciel de laboratoire ou une application de gestion réglementaire sont des cas fréquents.
Si ces systèmes fonctionnent, sont maintenus par l'éditeur et ne bloquent aucun usage, les garder sur site est une option raisonnable. Leur maintien doit cependant s'accompagner de deux vérifications : la date de fin de support annoncée, et la disponibilité des compétences nécessaires pour les exploiter. Un système stable aujourd'hui peut devenir un risque dans trois ans si la seule personne qui sait l'administrer quitte l'entreprise.
Les dépendances entre systèmes sont un critère moins visible, mais souvent décisif. Une base de données sur site peut être interrogée chaque minute par une dizaine d'applications, alimenter des traitements nocturnes et servir de référence à des échanges avec des partenaires. La migrer seule, sans ses consommateurs, revient à multiplier les échanges entre site et cloud et à allonger les temps de réponse.
Dans ce cas, la décision ne porte pas sur un système isolé mais sur un ensemble cohérent. Soit l'ensemble migre ensemble lors d'une même vague, soit il reste sur site jusqu'à ce que les dépendances aient été réduites. Couper un groupe de systèmes fortement liés entre deux environnements est l'une des causes les plus fréquentes d'hybride coûteux.
Le coût est le critère le plus discuté et le plus souvent mal calculé. La comparaison ne porte pas sur le prix d'un serveur face au prix d'une instance cloud, mais sur le coût complet de chaque option sur plusieurs années : migration, recette, réécriture des traitements, fonctionnement, licences, exploitation, et flux entre les deux environnements si le système reste sur site.
Un système dont l'infrastructure est déjà amortie, qui consomme peu et dont la migration demanderait plusieurs mois de reprise peut rester sur site sans difficulté. À l'inverse, un serveur à renouveler, une licence à renégocier ou un contrat d'hébergement à reconduire changent le calcul. Le coût total doit être recalculé à chaque échéance matérielle ou contractuelle, et non une seule fois au moment du cadrage. Les mécanismes qui font dériver une facture cloud sont analysés dans l'article Architecture Data et coûts : pourquoi la facture explose sans qu'on comprenne pourquoi ?
Deux critères suffisent à orienter la plupart des décisions : l'intensité de la contrainte réglementaire qui s'applique à la donnée, et le niveau de dépendance du traitement vis-à-vis des systèmes locaux. Une contrainte forte sans dépendance locale oriente vers un cloud qualifié. Une dépendance forte sans contrainte réglementaire oriente vers un hybride où le traitement reste près des équipements et où seules les données utiles à l'analyse remontent. Le maintien complet sur site se justifie quand les deux critères sont forts, et la migration s'impose quand aucun ne l'est.
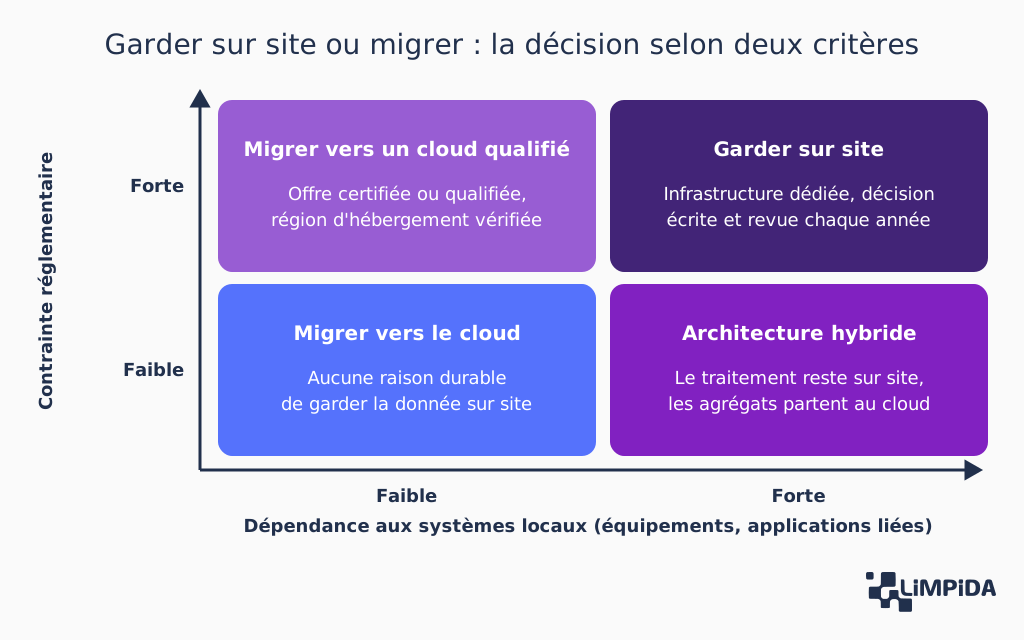
Le coût total et la stabilité des systèmes viennent ensuite affiner la recommandation. Ils peuvent retarder une migration, mais ils justifient rarement à eux seuls un maintien sur site durable.
Une architecture hybride vaut ce que valent ses flux. Les données on-premise et les données cloud doivent pouvoir être combinées par les usages sans créer de doublons, de versions concurrentes ni de coûts imprévus. Quatre décisions structurent l'organisation de ces flux.
Dès qu'une donnée existe dans les deux environnements, une question se pose : laquelle des deux versions est la référence ? Sans réponse explicite, chaque équipe choisit la version la plus accessible, et les écarts apparaissent dans les comités. Le chiffre d'affaires du siège ne correspond plus à celui des filiales, le stock affiché dans l'outil d'analyse diffère de celui du logiciel d'entrepôt.
La règle doit être fixée pour chaque domaine de données : où la donnée est créée, où elle est modifiée, et où elle est seulement copiée. Une donnée client créée dans un système sur site reste maîtrisée par ce système, et sa copie cloud est en lecture seule. Une donnée qui peut être modifiée des deux côtés finit toujours par diverger. Pour les données partagées par de nombreux systèmes, comme les produits, les clients ou les fournisseurs, la question rejoint celle du référentiel, traitée dans l'article Master Data Management : quand un référentiel unique devient-il nécessaire ?
La synchronisation entre site et cloud peut prendre plusieurs formes, qui n'ont ni le même coût ni la même complexité. Le choix dépend de la fraîcheur réellement attendue par les usages, et non de ce que la technique permet.
Trois modes couvrent l'essentiel des besoins :
Un même environnement combine souvent les trois. L'erreur fréquente consiste à généraliser la diffusion en continu par précaution, alors qu'une grande partie des usages se satisfait d'un transfert quotidien.
Les principaux fournisseurs de cloud facturent généralement les données qui sortent de leur environnement, alors que l'entrée des données est le plus souvent gratuite. Dans une architecture hybride, chaque flux qui redescend du cloud vers le site a donc un coût, proportionnel au volume transféré.
Ce coût reste faible tant que les flux sortants portent sur des résultats : indicateurs, extraits, fichiers de synthèse. Il devient significatif lorsque des applications sur site interrogent directement des tables volumineuses stockées dans le cloud, ou lorsqu'un traitement sur site relit chaque jour l'intégralité d'un historique. La règle de conception est simple : les traitements s'exécutent du côté où se trouvent les données, et seuls les résultats circulent. Les flux sortants doivent être mesurés dès la mise en service, avec une alerte sur les volumes inhabituels.
Chaque flux entre les deux environnements est un point d'exposition. La sécurité des données d'une architecture hybride repose sur des règles identiques des deux côtés, sans quoi l'environnement le moins protégé devient la voie d'accès la plus simple.
Plusieurs mesures sont à prévoir dès la conception des flux :
La gouvernance d'une architecture hybride fait la différence entre un choix qui reste pertinent et une situation qui se dégrade. Une décision prise au moment de la migration perd sa justification au fil des années : la réglementation évolue, les offres des fournisseurs changent, les systèmes vieillissent, les équipes tournent. Sans règles de suivi, l'hybride choisi devient un hybride subi sans que personne ne l'ait décidé.
Chaque système conservé sur site fait l'objet d'une fiche de décision courte. Elle précise le périmètre concerné, le critère qui justifie le maintien (réglementaire, latence, dépendances, coût, absence d'offre cloud), les options écartées et la raison de leur rejet, ainsi que les conditions qui feraient changer la décision. Une page suffit dans la plupart des cas.
Cette fiche protège l'organisation contre deux dérives. La première consiste à remettre en cause la décision à chaque changement d'interlocuteur, faute de trace des raisons initiales. La seconde consiste à la conserver indéfiniment alors que ses raisons ont disparu. Une décision d'architecture sans conditions de révision écrites se transforme en habitude et cesse d'être une décision.
👉 À lire aussi : Décisions d'architecture des données : comment les documenter pour qu'elles survivent aux équipes ?
La fiche de décision comporte une date de révision, fixée en fonction des échéances connues : fin de support d'un logiciel, renouvellement de matériel, fin d'un contrat d'hébergement, évolution annoncée d'une offre cloud. En l'absence d'échéance particulière, une revue annuelle permet de vérifier que les raisons du maintien sont toujours valables.
Un responsable est désigné pour chaque décision. Il ne s'agit pas nécessairement de la personne qui exploite le système, mais de celle qui a l'autorité pour proposer sa migration, son maintien ou son arrêt. Dans la plupart des organisations, ce rôle revient à l'architecte data ou au responsable du domaine concerné, avec une validation par le comité d'architecture. Sans nom associé, la date de révision passe sans que rien ne se produise.
Une architecture hybride se gouverne mal si chaque environnement a son propre inventaire. La cartographie des systèmes, des flux et des responsables doit couvrir les données on-premise et les données cloud dans un même référentiel, avec pour chaque système son emplacement, sa source de référence et sa décision associée.
Cette vue d'ensemble permet de répondre rapidement aux questions qui reviennent dans les comités : quelles données sensibles circulent entre les deux environnements, quels systèmes sur site arrivent en fin de support, quels flux coûtent le plus cher. Elle prolonge un arbitrage plus général sur l'organisation des données, développé dans l'article Centraliser ou distribuer les données : quels impacts réels sur l'architecture ?
Les coûts d'une architecture hybride dépassent largement la somme des factures d'hébergement. Une partie d'entre eux n'apparaît dans aucun budget, parce qu'elle se répartit entre plusieurs équipes ou se traduit en temps de travail plutôt qu'en lignes de facture. Les identifier permet de comparer honnêtement le maintien sur site et la migration.
Sept postes sont les plus souvent sous-estimés dans les comparaisons entre site et cloud :
Ces coûts sont justifiés lorsque le maintien sur site répond à une contrainte réelle. Ils deviennent une perte lorsque l'hybride résulte d'une migration inachevée. Le coût d'un hybride subi se mesure surtout en temps d'équipe, ce qui explique qu'il soit si rarement remis en question.
Une architecture hybride doit être résorbée lorsque les raisons qui justifiaient le maintien sur site ont disparu, ou lorsqu'elles n'ont jamais existé. La résorption ne signifie pas forcément tout migrer : elle peut aussi consister à confirmer un maintien par une décision écrite, à arrêter un système devenu inutile ou à regrouper des systèmes dispersés.
Plusieurs signaux indiquent qu'un hybride a cessé d'être un choix. Pris isolément, aucun ne suffit à conclure. Leur accumulation, en revanche, justifie une revue complète des systèmes restés sur site.
Six signaux méritent une attention particulière :
La résorption suit la même logique que la décision initiale : un examen système par système, à partir des critères de réglementation, de dépendance, de stabilité et de coût. Pour chaque système sans raison valable de rester sur site, trois issues sont possibles : migrer lors d'une prochaine vague, arrêter si plus aucun usage ne le justifie, ou maintenir avec une décision désormais écrite.
L'ordre de traitement privilégie les systèmes qui génèrent le plus de coûts cachés : ceux qui alimentent de nombreux flux, ceux dont les données sont modifiées des deux côtés, ceux qui arrivent à une échéance matérielle ou contractuelle. Une résorption menée sur ces systèmes réduit rapidement la complexité de l'ensemble, sans attendre un nouveau programme de migration.
Les différences entre un hybride choisi et un hybride subi se lisent sur les mêmes critères : la justification du maintien, la règle de référence des données, la conception des flux, le suivi des coûts, la gouvernance et la trajectoire. La comparaison critère par critère permet de situer chaque système resté sur site.
| Critère | Décision Hybride choisi | Inertie Hybride subi |
|---|---|---|
| Justification du maintien sur site | Un critère identifié pour chaque système : texte réglementaire, contrat, latence, dépendances ou coût total. | Aucune raison écrite : le système est resté sur site parce que la migration s'est arrêtée. |
| Source qui fait foi | Une source de référence désignée pour chaque donnée partagée, les copies sont en lecture seule. | La même donnée est modifiée sur site et dans le cloud, et les deux versions divergent. |
| Conception des flux | Des flux conçus et documentés, qui transportent des résultats plutôt que des volumes bruts. | Des extractions ajoutées au fil des demandes, sans vue d'ensemble ni surveillance. |
| Transferts sortants | Mesurés dès la mise en service, avec une alerte sur les volumes inhabituels. | Découverts sur la facture, en hausse plus rapide que les usages. |
| Sécurité | Identités, rôles et classification identiques dans les deux environnements. | Des règles différentes de chaque côté, l'environnement le moins protégé devient le point faible. |
| Gouvernance | Une fiche de décision, un responsable nommé et une date de révision par système. | Personne ne sait qui peut décider de migrer, de garder ou d'arrêter le système. |
| Trajectoire | La décision est réexaminée à chaque échéance de support, de matériel ou de contrat. | Les échéances sont traitées par des prolongations, sans réexamen du maintien. |
Garder des données sur site après une migration cloud n'est ni une faiblesse ni une solution de facilité. C'est une décision d'architecture comme les autres, qui doit reposer sur un critère identifié et non sur l'inertie d'un projet interrompu. Les contraintes réglementaires vérifiées, la proximité des systèmes industriels, l'absence d'offre cloud satisfaisante et les dépendances fortes en sont les justifications les plus solides.
La valeur d'une architecture hybride se joue ensuite dans son exploitation. Une source de référence désignée pour chaque donnée, des flux qui transportent des résultats plutôt que des volumes bruts, une sécurité identique des deux côtés et des transferts sortants mesurés évitent l'essentiel des coûts cachés. Un système maintenu sur site avec une fiche de décision, un responsable et une date de révision reste un choix. Le même système sans ces trois éléments devient un coût que plus personne ne justifie.
Chaque échéance (fin de support, renouvellement de matériel, nouvelle offre cloud, évolution réglementaire) est l'occasion de reprendre la décision. Les organisations qui tiennent ce rythme conservent un hybride lisible, dont chaque composant a une raison d'être. Les autres découvrent, quelques années après la migration, qu'elles exploitent deux environnements complets sans savoir lequel sert réellement leurs usages.
Une architecture hybride des données répartit les données et les traitements entre une infrastructure gérée par l'entreprise et un ou plusieurs environnements cloud. Les deux environnements sont reliés par des flux maîtrisés, et une règle précise ce qui va où et pourquoi.
Trois catégories de données ont une raison durable de rester sur site : celles soumises à une contrainte réglementaire ou contractuelle forte, celles exploitées en temps réel par des systèmes industriels ou opérationnels, et celles d'applications stables sans version cloud satisfaisante. Chaque maintien doit être décidé par écrit.
Dans la plupart des cas, non. Les principaux textes applicables en France encadrent le choix de l'hébergeur, le lieu de stockage ou les transferts de données, sans interdire le cloud. La contrainte doit être rattachée à un texte, un contrat ou une politique interne précis.
Un hybride choisi repose sur une décision écrite pour chaque système maintenu sur site, avec un critère identifié et une date de révision. Un hybride subi résulte d'une migration interrompue, sans raison particulière de garder les systèmes restants.
La synchronisation se choisit selon la fraîcheur réellement attendue par chaque usage. Trois modes couvrent l'essentiel des besoins, et une même architecture les combine souvent.
Les coûts cachés d'une architecture hybride se traduisent surtout en temps d'équipe, ce qui les rend peu visibles dans les budgets. Ils sont justifiés lorsque le maintien sur site répond à une contrainte réelle.
Chaque décision de maintien sur site doit avoir un responsable nommé, qui a l'autorité pour proposer une migration, un maintien ou un arrêt. Ce rôle revient le plus souvent à l'architecte data ou au responsable du domaine concerné, avec une validation en comité d'architecture.
Une architecture hybride doit être résorbée lorsque les raisons du maintien sur site ont disparu ou n'ont jamais existé. La résorption peut aboutir à une migration, à un arrêt ou à un maintien confirmé par une décision écrite.