ARCHITECTURE
La migration des données vers le cloud commence par les usages, pas par les serveurs : inventorier les flux et leurs dépendances, choisir un premier périmètre visible mais peu risqué, poser le socle de sécurité et de gouvernance, puis avancer par vagues. Un système stable, contraint ou en fin de vie peut rester en place ou s'arrêter.
Dans la plupart des organisations, la décision de passer au cloud est déjà prise. Elle figure dans le plan stratégique de la DSI, elle a parfois été déclenchée par la fin d'un contrat d'hébergement ou par l'arrêt du support d'une base de données. Ce qui reste flou, c'est la manière de s'y prendre : quel périmètre déplacer en premier, dans quel ordre, avec quelle équipe, et surtout ce qu'il vaut mieux ne pas déplacer du tout.
L'idée reçue la plus répandue consiste à voir la migration comme une opération purement technique. On recense les serveurs, on choisit un fournisseur, on transfère les bases, on rebranche les tableaux de bord. Ce raisonnement produit des plateformes cloud qui reproduisent fidèlement les défauts de l'existant, avec une facture mensuelle en plus. Les doublons de données, les règles de calcul divergentes entre directions et les flux que plus personne ne maîtrise sont transférés avec le reste.
L'angle inverse est tout aussi risqué. Certaines organisations profitent de la migration pour tout reconstruire : nouveau modèle de données, nouveaux outils, nouvelle organisation. Le projet devient alors une refonte complète, dont la durée et le coût dépassent largement ce qui était prévu, et dont les premiers bénéfices arrivent trop tard pour maintenir l'adhésion des métiers.
Entre ces deux excès, il existe une voie plus pragmatique. Elle repose sur une série de décisions explicites, prises système par système : migrer à l'identique, adapter, reconstruire, garder sur site ou arrêter. Ces décisions se prennent à partir des usages réels des données, des contraintes réglementaires et du coût total, et elles déterminent l'ordre dans lequel la migration avance.
Le terme « migration vers le cloud » recouvre des opérations très différentes, qui n'ont ni le même coût, ni le même risque, ni le même bénéfice. Les confondre conduit à des budgets mal calibrés et à des attentes déçues. Clarifier le vocabulaire est donc la première étape d'un cadrage utile.
Pour chaque système concerné, la migration peut prendre l'une des trois formes suivantes. Chacune correspond à un niveau d'effort et à un niveau de transformation différents.
Une même migration combine presque toujours les trois formes. Le travail de cadrage consiste précisément à attribuer la bonne forme à chaque système, et à ne pas appliquer la même recette partout.
La migration change l'infrastructure. Elle ne change pas, par elle-même, la qualité des données, les règles de calcul ni la façon dont les responsabilités sont réparties. Une donnée client saisie de trois manières différentes dans trois applications restera saisie de trois manières différentes une fois dans le cloud.
Plusieurs sujets sont régulièrement confiés à la migration alors qu'ils relèvent d'autres décisions :
Ces sujets ne doivent pas être réglés avant de migrer, ce qui repousserait le projet indéfiniment. Ils doivent en revanche être identifiés, et certains doivent être traités en même temps que les premiers périmètres migrés.
👉 À lire aussi : Architecture des données cible : comment la définir à partir des usages ?
Les retours d'expérience sur les migrations de données convergent sur un point : le résultat est rarement mauvais sur le plan technique, mais souvent décevant sur le plan de la valeur. Les métiers ne voient pas de différence, les coûts augmentent, et les anciens systèmes continuent de tourner. Trois causes reviennent de façon récurrente.
Migrer à l'identique est tentant : c'est rapide, le risque technique est faible et le calendrier se tient. Mais une plateforme cloud alimentée par les mêmes flux, avec le même modèle et les mêmes traitements, produit les mêmes résultats que l'ancienne. Le seul changement visible pour les métiers est alors une période d'instabilité pendant la bascule.
Le problème s'aggrave quand la migration à l'identique devient la règle par défaut pour tenir une échéance. Les traitements lourds, conçus pour un serveur dont la puissance était payée une fois pour toutes, consomment du calcul en continu une fois dans le cloud. Les requêtes mal écrites, invisibles sur site, deviennent des lignes de facture.
Beaucoup de migrations démarrent sous la contrainte d'une date : fin du contrat d'hébergement, fin du support d'un logiciel, renouvellement de matériel. Cette date est réelle et elle doit être respectée. Elle ne dit rien, en revanche, de l'ordre dans lequel les périmètres doivent migrer ni de la forme de migration à retenir.
Quand l'échéance devient le seul critère, le plan de migration suit la cartographie des serveurs plutôt que celle des usages. Des domaines fortement liés sont séparés, des flux sont coupés en deux, et des dépendances oubliées apparaissent au moment de la bascule. Une démarche plus robuste consiste à identifier ce qui doit impérativement quitter l'ancien environnement à la date butoir, puis à organiser le reste selon la valeur et le risque.
Sur site, le coût d'une plateforme de données est largement fixe : matériel, licences, hébergement. Dans le cloud, il devient variable et dépend directement de l'usage. Ce changement de modèle est souvent sous-estimé. Les équipes découvrent le coût réel plusieurs mois après la mise en production, une fois les habitudes prises.
Ce décalage n'est pas une fatalité, mais il exige des règles posées dès le départ : étiquetage des ressources par projet, budgets par environnement, alertes de dépassement, revue régulière des traitements les plus consommateurs. Le sujet est développé dans l'article Architecture Data et coûts : pourquoi la facture explose sans qu'on comprenne pourquoi ?, qui détaille les mécanismes les plus fréquents.
La question « par quoi commencer ? » est celle qui conditionne le plus la réussite du projet. Le premier périmètre migré sert de référence pour tout le reste : il valide les choix techniques, il installe les méthodes de travail et il donne aux métiers une première preuve de valeur. Un mauvais choix à ce stade se paie sur toute la durée de la migration.
Le point de départ est la liste des usages que la plateforme doit servir : pilotage financier, suivi commercial, prévision des stocks, reporting réglementaire, alimentation d'un modèle d'IA. Pour chaque usage, il s'agit d'identifier qui l'utilise, à quelle fréquence, avec quel niveau d'exigence sur la fraîcheur et la fiabilité des données.
Cette liste permet de raisonner en valeur plutôt qu'en volume. Un entrepôt de plusieurs téraoctets consulté une fois par trimestre n'a pas la même priorité qu'un flux de quelques gigaoctets qui alimente chaque matin le pilotage des ventes. La taille d'un système ne dit rien de son importance pour l'entreprise. L'article Quels usages une plateforme data doit réellement supporter ? propose une grille pour qualifier ces usages.
Une fois les usages connus, il faut remonter jusqu'aux données qui les alimentent. L'inventaire porte sur les sources, les flux d'intégration, les traitements de transformation et les points de consommation (tableaux de bord, exports, applications). C'est souvent l'étape la plus longue, car une partie de ces dépendances n'est documentée nulle part.
Plusieurs informations doivent être collectées pour chaque flux, afin de préparer les décisions qui suivront :
Les outils de data lineage, qui retracent le parcours d'une donnée de sa source à son usage, accélèrent ce travail lorsque l'existant est déjà instrumenté. Dans le cas contraire, l'inventaire combine l'analyse des journaux d'exécution, l'examen des requêtes et des entretiens avec les équipes.
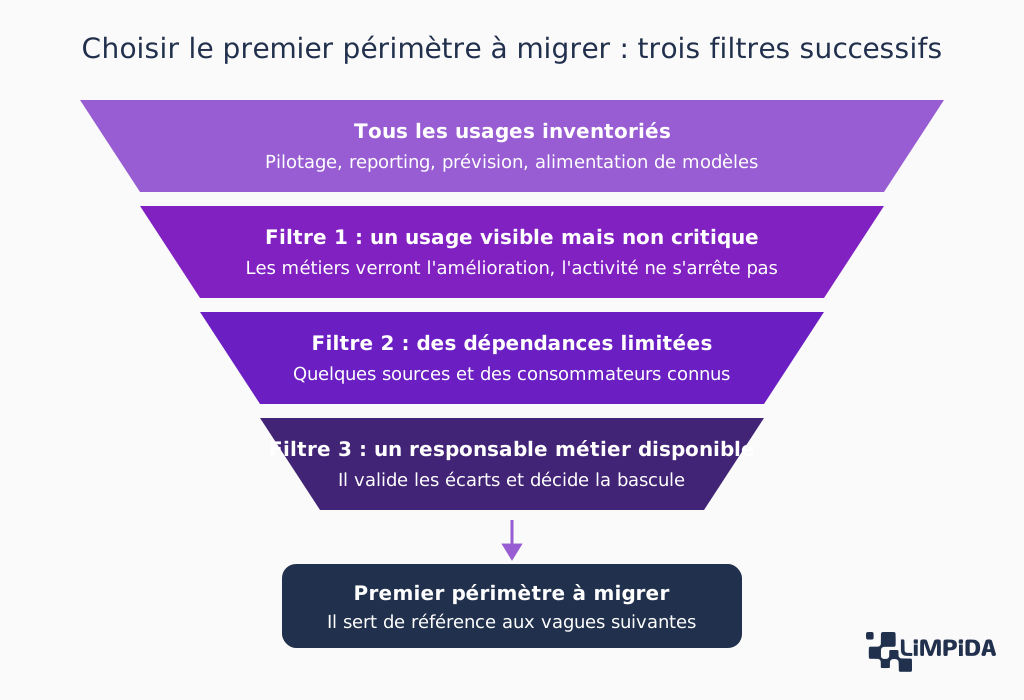
Le premier périmètre doit être suffisamment visible pour démontrer une valeur, et suffisamment maîtrisé pour ne pas mettre l'entreprise en difficulté en cas de problème. Trois critères permettent de le sélectionner parmi les usages inventoriés.
Le périmètre pilote doit concerner un usage que les métiers connaissent et dont ils percevront l'amélioration. Il ne doit pas, en revanche, porter sur un processus dont l'interruption bloquerait l'activité, comme la paie, la facturation ou un reporting réglementaire à échéance fixe. Un tableau de bord de suivi commercial ou un reporting de pilotage opérationnel constituent souvent de bons candidats.
Plus un périmètre dépend de sources et de traitements partagés, plus sa migration entraîne d'effets de bord. Le premier périmètre doit pouvoir être isolé : quelques sources, des traitements identifiés, des consommateurs connus. Un domaine qui alimente la moitié du système d'information n'est pas un bon point de départ, même s'il est stratégique.
La recette d'un périmètre migré ne peut pas être purement technique. Il faut qu'une personne du métier compare les résultats, valide les écarts et décide de la bascule. Sans ce responsable, identifié comme data owner du périmètre, la validation traîne et la confiance des utilisateurs ne se construit pas.
La sélection fonctionne comme une suite de filtres : chaque critère réduit la liste des candidats, jusqu'à un périmètre qui réunit les trois conditions.
Tout ne doit pas migrer. Cette affirmation paraît évidente, mais elle est rarement traduite dans les plans de migration, qui visent souvent le transfert de l'ensemble de l'existant. Or, pour une partie des systèmes, rester sur site ou s'arrêter est la meilleure décision, sur le plan économique comme sur le plan des risques.
Un système qui fonctionne, dont les coûts sont maîtrisés et qui ne bloque aucun usage futur n'a pas vocation à migrer en priorité. C'est souvent le cas d'applications métier anciennes mais fiables, ou de bases opérationnelles dont l'éditeur ne propose pas de version cloud satisfaisante.
Le bon réflexe consiste à vérifier trois points avant de décider : le système bloque-t-il un usage attendu par les métiers ? Son maintien sur site crée-t-il un risque (fin de support, compétences rares, sécurité) ? Son coût de fonctionnement est-il supérieur à celui d'une version cloud, migration comprise ? Si les trois réponses sont négatives, le système peut rester en place, au moins pour les premières vagues.
Certaines données font l'objet d'exigences particulières sur leur lieu de stockage ou sur l'hébergeur. C'est le cas des données de santé, dont l'hébergement en France est soumis à une certification d'hébergeur de données de santé (HDS). C'est aussi le cas de données sensibles pour lesquelles certaines organisations exigent un prestataire qualifié SecNumCloud par l'ANSSI, ou de données dont le transfert hors de l'Union européenne est encadré par le RGPD.
Ces contraintes n'interdisent pas le cloud. Elles restreignent le choix des fournisseurs et des régions d'hébergement, et elles peuvent justifier le maintien de certaines données sur une infrastructure dédiée. La question doit être posée avec le délégué à la protection des données et la sécurité dès le cadrage, et non au moment de la mise en production. L'article RGPD, IA Act, normes ISO : structurer sa conformité Data & IA présente le cadre réglementaire à prendre en compte.
L'inventaire des flux révèle systématiquement des traitements que personne ne consulte, des tables alimentées pour un projet arrêté et des rapports produits chaque semaine pour des destinataires qui ont quitté l'entreprise. Migrer ces éléments coûte du temps de recette et du budget de fonctionnement, sans aucun bénéfice.
La migration est le moment idéal pour les arrêter. Une méthode simple consiste à suspendre le traitement pendant quelques semaines et à observer si quelqu'un réclame le résultat. Si personne ne se manifeste, le traitement est archivé puis supprimé. Ce nettoyage réduit souvent de façon significative le périmètre à migrer.
Pour de nombreuses organisations, la cible n'est pas un environnement entièrement cloud, mais une architecture hybride : une partie des données et des traitements reste sur site, une autre passe dans le cloud, et des flux maîtrisés relient les deux. Ce choix est légitime lorsqu'il est délibéré, avec des règles claires sur ce qui va où et pourquoi.
Il devient problématique lorsqu'il résulte d'une migration interrompue. Deux environnements à exploiter, des compétences à maintenir sur les deux, des flux dupliqués et des coûts qui s'additionnent : l'hybride subi est souvent la situation la plus chère. La différence entre les deux tient à une décision écrite, documentée et revue régulièrement. L'article Décisions d'architecture des données : comment les documenter pour qu'elles survivent aux équipes ? propose un format pour consigner ces arbitrages.
Pour chaque système recensé, la décision se situe sur une échelle qui va de l'option la plus légère à la plus lourde. Chaque position de cette échelle correspond à une situation précise, qui permet de savoir où placer le système étudié.
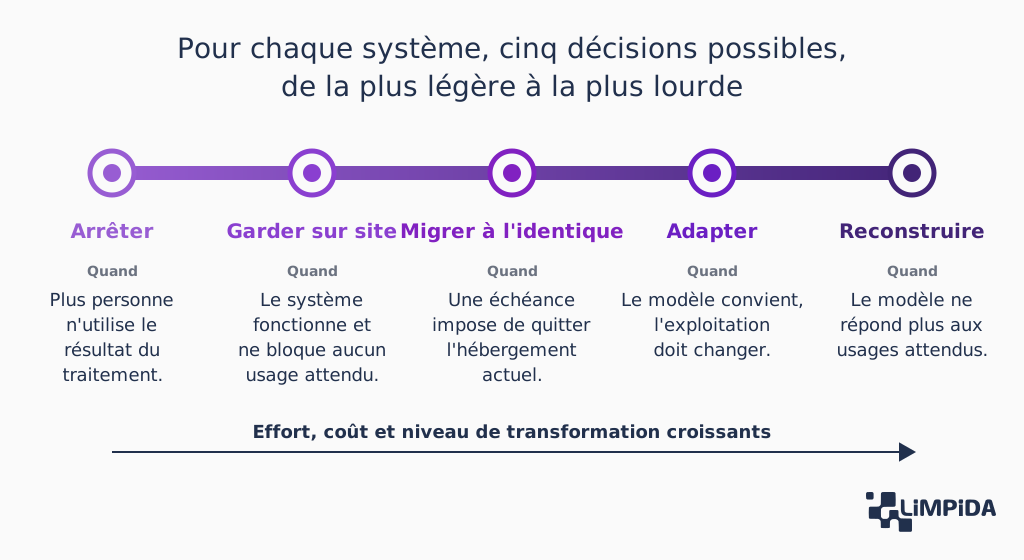
Chaque décision comporte aussi un risque propre, qu'il vaut mieux connaître avant de la retenir. Les cinq options se comparent sur trois critères : les situations où elles s'appliquent, un exemple de système concerné et le principal risque associé.
| Décision | Quand la retenir | Exemple de système concerné | Principal risque |
|---|---|---|---|
| Arrêter | Le traitement ne sert plus aucun usage identifié et personne ne réclame son résultat après une suspension test. | Un rapport hebdomadaire envoyé à une liste de diffusion que plus personne ne lit. | Supprimer un traitement encore utilisé ponctuellement, par exemple lors d'une clôture annuelle. |
| Garder sur site | Le système fonctionne, ne bloque aucun usage et son maintien ne crée pas de risque particulier. | Une application métier ancienne mais fiable, sans version cloud satisfaisante. | Laisser s'installer une architecture hybride sans décision écrite ni date de révision. |
| Migrer à l'identique | Une échéance impose de quitter l'hébergement actuel et le système ne présente pas de défaut de fond. | Une base opérationnelle stable dont le contrat d'hébergement arrive à son terme. | Transférer les défauts existants et payer en continu des traitements mal optimisés. |
| Adapter | Le modèle de données convient, mais l'exploitation doit évoluer pour tirer parti des services cloud. | Un entrepôt de données dont les traitements nocturnes sont réécrits pour l'outil d'orchestration cible. | Sous-estimer la réécriture des traitements et le temps de recette associé. |
| Reconstruire | Le modèle ne répond plus aux usages attendus et ses défauts bloquent les métiers. | Un domaine dont les règles de calcul divergent d'une direction à l'autre. | Glisser vers une refonte complète dont les bénéfices arrivent trop tard. |
Une fois les décisions prises système par système, il reste à les ordonner dans le temps. Une migration réussie avance par vagues successives, chacune s'appuyant sur ce que la précédente a mis en place. Trois vagues structurent la plupart des projets, suivies d'une étape souvent négligée : l'arrêt des anciens systèmes.
Avant de migrer la moindre donnée, plusieurs fondations doivent être en place. Elles conditionnent la sécurité et la maintenabilité de tout ce qui suivra, et elles sont très coûteuses à reprendre après coup.
Le socle couvre en priorité les éléments suivants :
Le choix du type de stockage analytique fait aussi partie de cette première vague. Entrepôt de données, data lake ou lakehouse : chaque option répond à des usages différents, comme le détaille l'article Data Lake vs Data Warehouse vs Data Lakehouse : un comparatif pour les décideurs data.
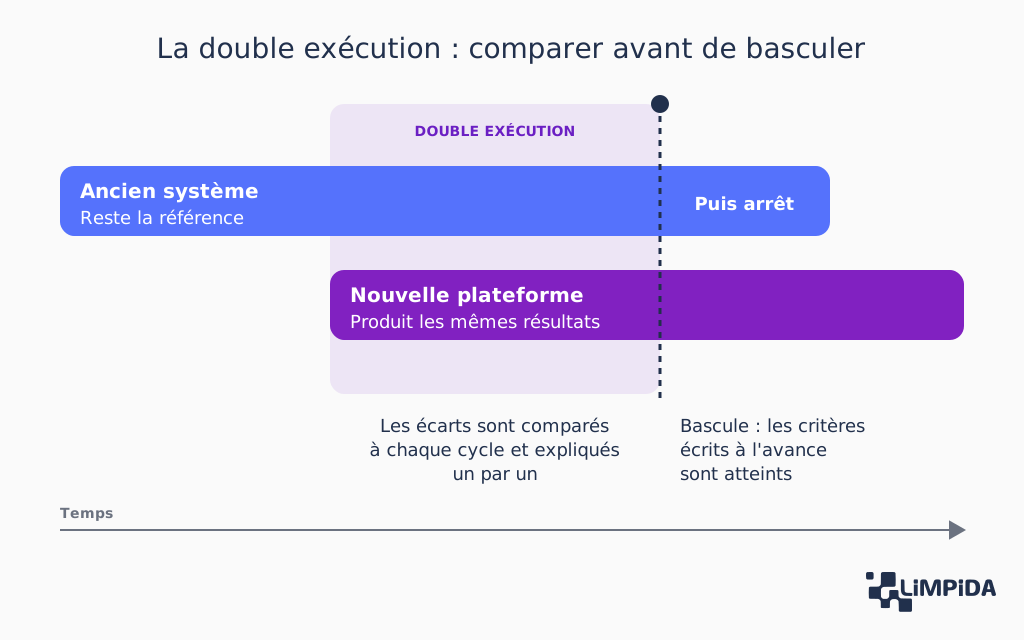
Le premier périmètre est migré pendant que l'ancien système continue de fonctionner. Pendant plusieurs semaines, les deux environnements produisent les mêmes résultats en parallèle, et l'équipe compare les chiffres. Cette double exécution est la seule manière fiable de démontrer que la nouvelle plateforme produit des résultats justes.
La comparaison porte sur des indicateurs définis à l'avance : nombre de lignes, totaux par période, valeurs des indicateurs clés, délais de mise à disposition. Les écarts sont expliqués un par un. Certains révèlent une erreur de migration, d'autres une erreur ancienne que personne n'avait détectée. Les critères de bascule doivent être écrits avant le début de la double exécution, sinon la décision de basculer se repousse indéfiniment.
La période de double exécution s'enchaîne toujours de la même façon : les deux systèmes fonctionnent ensemble, la bascule intervient une fois les critères atteints, puis l'ancien système est arrêté.
Une fois le premier périmètre basculé, la migration s'accélère. Les méthodes, les outils de comparaison et les conventions existent ; il reste à les appliquer domaine par domaine. L'ordre des domaines suit les décisions prises pendant le cadrage : valeur pour les métiers, niveau de dépendance, contraintes réglementaires, échéances techniques.
Cette vague est aussi le moment de traiter les domaines qui nécessitent une reconstruction. Ils sont rarement migrés en premier, car leur complexité ralentirait l'apprentissage de l'équipe. Ils bénéficient en revanche du socle et des méthodes éprouvés sur les périmètres précédents. Pour les domaines concernés par une refonte, l'article Refonte de l'architecture data : quand est-ce vraiment nécessaire ? aide à vérifier que l'investissement est justifié.
Une migration n'est terminée que lorsque l'ancien système est arrêté. Tant qu'il tourne, il coûte : licences, hébergement, maintenance, compétences. Il entretient aussi une confusion, car certains utilisateurs continuent de s'y connecter et de produire des chiffres qui ne correspondent plus à ceux de la nouvelle plateforme.
L'arrêt doit être planifié dès le début, avec une date et un responsable. Il comprend l'archivage des données à conserver pour des raisons légales, la coupure des accès, la résiliation des contrats et l'information des utilisateurs. Une migration sans date d'arrêt de l'ancien système produit presque toujours une architecture hybride non voulue.
Une migration modifie le chemin que suivent les données, et chaque modification est une occasion d'erreur : un format de date interprété différemment, un caractère accentué mal converti, une jointure qui perd des lignes, un arrondi appliqué à une autre étape du calcul. Ces erreurs sont rarement spectaculaires. Elles produisent des écarts de quelques unités ou de quelques pourcents, qui suffisent pourtant à faire perdre la confiance des utilisateurs.
Les comparaisons manuelles entre l'ancien et le nouveau système ne tiennent pas sur la durée. Elles sont faites avec soin sur le premier périmètre, puis de moins en moins à mesure que les vagues s'enchaînent. La solution consiste à automatiser une série de contrôles, exécutés à chaque cycle de traitement pendant toute la double exécution.
Ces contrôles couvrent plusieurs niveaux, du plus simple au plus fin :
Ces contrôles ne disparaissent pas après la bascule. Une partie d'entre eux devient le socle des contrôles de qualité permanents de la nouvelle plateforme. Le travail réalisé pour la migration sert ainsi au fonctionnement courant.
La double exécution fait apparaître des écarts qui ne viennent pas de la migration. Une règle de gestion appliquée de façon incohérente depuis des années, une table de correspondance jamais mise à jour, un traitement qui ignorait silencieusement certaines lignes : la comparaison met au jour des défauts que l'ancien système masquait.
Face à ces écarts, deux réactions sont possibles. La première consiste à reproduire le défaut dans le nouveau système pour obtenir des chiffres identiques. La seconde consiste à corriger, en expliquant aux métiers pourquoi les nouveaux chiffres diffèrent des anciens. La seconde option est presque toujours préférable, à condition que la correction soit validée par le responsable métier et communiquée aux utilisateurs avant la bascule. Une correction découverte par les utilisateurs après la bascule est perçue comme une erreur de la nouvelle plateforme.
La migration est le seul moment où chaque table, chaque flux et chaque traitement est examiné un par un. C'est donc le moment le moins coûteux pour documenter : définition des champs, propriétaire, fréquence de mise à jour, règles de calcul. Reporter cette documentation à plus tard revient en pratique à ne jamais la faire.
Cette documentation alimente le catalogue de données de la nouvelle plateforme. Elle n'a pas besoin d'être exhaustive dès le départ : décrire les données utilisées par les usages prioritaires suffit à rendre la plateforme compréhensible pour ses premiers utilisateurs. Le reste s'enrichit au fil des vagues, selon le même principe que la migration elle-même.
Le coût d'une migration ne se limite pas au budget du projet. Il comprend une période de transition pendant laquelle les dépenses s'additionnent, puis un coût de fonctionnement dont la structure diffère de celle de l'existant. Les anticiper permet d'éviter les arbitrages en urgence au milieu du projet.
Ce sont les postes qui figurent dans tous les budgets : stockage, puissance de calcul, licences des outils, prestations d'accompagnement. Ils sont estimables à partir des volumes de données et des usages inventoriés, avec une marge d'incertitude importante tant que les premiers traitements n'ont pas tourné dans l'environnement cible.
La facturation à la consommation rend ces estimations sensibles à la qualité des traitements. Une requête qui parcourt l'intégralité d'une table chaque heure n'a pas le même coût qu'une requête qui ne lit que les données modifiées. Le premier périmètre fournit les mesures réelles qui permettent d'affiner le budget des vagues suivantes.
Plusieurs postes sont régulièrement oubliés dans les estimations initiales. Leur cumul explique une grande partie des écarts constatés en cours de projet :
Le pilotage des coûts ne s'improvise pas après la mise en production. Il s'installe en même temps que le socle, avec des règles simples : chaque ressource est rattachée à un projet ou à un domaine, chaque environnement dispose d'un budget, et des alertes signalent les dépassements. Une revue mensuelle identifie les traitements les plus consommateurs et les optimisations possibles.
Ce pilotage a aussi une dimension organisationnelle. Quelqu'un doit être responsable du budget de la plateforme, avec l'autorité nécessaire pour demander l'optimisation d'un traitement ou l'arrêt d'un environnement inutilisé. L'arbitrage entre performance, coût et contrôle est analysé dans l'article Architecture Data : comment concilier performance, coûts et gouvernance ?
Une migration confiée uniquement à la DSI reste un projet d'infrastructure. Une migration pilotée uniquement par les métiers bute sur les contraintes techniques. La gouvernance du projet doit associer les deux, avec des rôles précis.
Le comité de pilotage réunit un responsable de la DSI, chargé du socle, de la sécurité et du calendrier technique, et un représentant des métiers, chargé de la priorisation des usages et de la validation des résultats. Ce binôme arbitre l'ordre des périmètres, les décisions de garder ou d'arrêter certains systèmes et les écarts de budget.
Ce partage évite deux dérives fréquentes. La première consiste à migrer dans l'ordre le plus simple techniquement, sans considération pour la valeur métier. La seconde consiste à accumuler les demandes d'évolution pendant la migration, jusqu'à transformer le projet en refonte complète.
L'architecte data conçoit la cible et garantit sa cohérence au fil des vagues. Il définit les conventions, choisit les services, arbitre entre les options techniques et veille à ce que les décisions prises pour un périmètre ne compliquent pas les suivants. Sur une migration d'ampleur, ce rôle doit être tenu par une personne identifiée, disponible et légitime auprès des équipes.
L'architecte data veille aussi à la durabilité des choix. Une décision prise sous la contrainte du calendrier doit être documentée, avec ses raisons et ses conditions de révision. L'article Architecture Data : comment faire des choix qui tiennent dans le temps ? développe cette exigence.
Chaque domaine migré doit avoir un responsable métier capable de valider les résultats. C'est lui qui décide si un écart est acceptable, qui signe la bascule et qui informe les utilisateurs. Sans ce rôle, la recette se réduit à des contrôles techniques qui vérifient que les données sont arrivées, mais pas qu'elles sont justes.
La migration est souvent l'occasion de formaliser ces responsabilités, quand elles n'existaient pas auparavant. Elle révèle aussi les zones où personne ne se sent responsable de la donnée, un constat développé dans l'article Qui est réellement responsable de la qualité des données ?
Une migration de données s'étale souvent sur plusieurs mois, voire plusieurs années. Pendant cette période, certains signaux indiquent que le projet dérive et qu'il faut s'arrêter pour réajuster. Les repérer tôt évite de découvrir le problème au moment du bilan.
Les signaux suivants méritent une revue immédiate en comité de pilotage :
Aucun de ces signaux n'impose d'arrêter le projet. Chacun impose en revanche une décision explicite : corriger, ralentir, réduire le périmètre ou changer de forme de migration pour un domaine donné.
👉 À lire aussi : Quand une plateforme data devient trop complexe pour être gouvernée ?
Une migration des données vers le cloud réussie ne dépend pas d'abord du choix du fournisseur ou des outils. Elle dépend d'une série de décisions prises avant le premier transfert, consignées par écrit et partagées entre la DSI et les métiers. Ces décisions servent ensuite de référence à chaque comité de pilotage.
Cinq décisions structurent l'ensemble du projet :
Une organisation qui dispose de ces cinq décisions écrites avant de commencer connaît sa cible, l'ordre de ses vagues et ses critères de succès. Le choix des outils vient ensuite, et il est d'autant plus simple que les usages sont clairs. Pour cette étape, l'article Quels outils choisir pour initier une Modern Data Stack pragmatique ? propose une sélection raisonnée.
Une migration des données vers le cloud commence par l'inventaire des usages que la plateforme doit servir, puis des flux et des dépendances qui les alimentent. Ce travail permet de choisir un premier périmètre et de prendre une décision explicite pour chaque système avant tout transfert.
Non. Pour une partie des systèmes, rester sur site ou s'arrêter est la meilleure décision. Le choix se fait système par système, à partir des usages, des contraintes réglementaires et du coût total.
Ces trois formes de migration n'ont ni le même coût, ni le même bénéfice. Une même migration les combine presque toujours, et le cadrage consiste à attribuer la bonne forme à chaque système.
Le premier périmètre doit démontrer une valeur sans mettre l'activité en danger. Trois critères permettent de le sélectionner parmi les usages inventoriés.
La double exécution est la période pendant laquelle l'ancien système et la nouvelle plateforme produisent les mêmes résultats en parallèle. Elle permet de démontrer que les données migrées sont justes avant de basculer.
Le coût d'une migration comprend une période de transition où les dépenses s'additionnent, puis un coût de fonctionnement variable, lié à l'usage. Plusieurs postes sont régulièrement oubliés dans les estimations initiales.
La migration doit être pilotée conjointement par la DSI et les métiers. Une migration confiée uniquement à la DSI reste un projet d'infrastructure, et une migration pilotée uniquement par les métiers bute sur les contraintes techniques.