IA
Avant un premier cas d'usage IA, quatre décisions data suffisent : le résultat métier attendu et la façon de le mesurer, l'accès aux données nécessaires et ses conditions d'usage, une personne qui répond de ces données, et le niveau de qualité suffisant pour cet usage précis. Le reste de la stratégie data se construit avec les cas d'usage suivants.
Dans beaucoup de comités de direction, la question de l'IA se présente comme un choix entre deux calendriers. Une partie des dirigeants veut lancer des cas d'usage tout de suite, pour ne pas prendre de retard sur les concurrents. L'autre partie demande d'abord une stratégie data complète : plateforme cible, gouvernance, catalogue, qualité des données, organisation.
Chacune des deux positions a ses arguments, et chacune produit des échecs reconnaissables. La stratégie data complète prend des mois et se construit sans savoir quels usages elle devra servir. Le cas d'usage lancé sans aucune décision data avance vite jusqu'à la démonstration, puis s'arrête lorsqu'il faut des données réelles, un responsable et un niveau de fiabilité. L'ordre entre stratégie data et IA compte moins que le périmètre des décisions prises avant le premier cas d'usage.
Les analystes observent les mêmes blocages. Gartner prévoyait qu'au moins 30 % des projets d'IA générative seraient abandonnés après la preuve de concept d'ici la fin de 2025, en citant la mauvaise qualité des données, des contrôles de risques insuffisants, des coûts croissants ou une valeur métier peu claire (Gartner, communiqué du 29 juillet 2024). En février 2025, le même cabinet indiquait que 63 % des organisations n'ont pas, ou ne savent pas si elles ont, les pratiques de gestion des données adaptées à l'IA, d'après une enquête menée en juillet 2024 auprès de 1 203 responsables de la gestion des données (Gartner, communiqué du 26 février 2025).
Ce second communiqué contient une précision utile : des données prêtes pour l'IA doivent être représentatives du cas d'usage. Cette précision déplace le débat. Le cas d'usage visé détermine quelles décisions data sont indispensables tout de suite, et lesquelles peuvent attendre. La stratégie data d'ensemble se nourrit ensuite de ce que chaque cas d'usage révèle.
Une stratégie data complète n'est pas un prérequis au premier cas d'usage IA. L'absence de toute décision data n'est pas une option pour autant : les deux excès ont des coûts différents, qui apparaissent à des moments différents du projet.
Une stratégie data complète couvre la plateforme cible, le modèle de gouvernance, l'organisation des rôles, la qualité des données, l'architecture et le plan d'investissement. Construite avant tout cas d'usage, elle doit anticiper des besoins que personne n'a encore exprimés. Les choix d'architecture reposent alors sur des hypothèses, et la gouvernance fixe des règles pour des données dont l'usage reste inconnu.
Pendant ce temps, les directions métier ne voient aucun résultat. Certaines lancent leurs propres expérimentations, avec des outils grand public et des extractions manuelles. La stratégie data conçue pour encadrer l'IA arrive alors après des usages qui se sont installés sans elle.
Le scénario inverse est plus courant. Une équipe interne ou un prestataire construit une démonstration sur un extrait de données préparé à la main. La démonstration convainc le comité. Le passage en production révèle ensuite que l'extrait ne reflétait pas les données réelles, que l'accès aux systèmes sources n'a jamais été autorisé, ou que personne ne sait qui doit corriger les anomalies.
Ces difficultés ne sont pas propres à l'IA. Elles existaient déjà sur les projets décisionnels et de reporting, et l'IA les rend plus visibles et plus coûteuses. Un modèle alimenté par des données dont personne ne répond produit des résultats dont personne ne répond non plus.
👉 À lire aussi : L'IA ne pose pas de nouveaux problèmes, elle révèle les anciens
Entre ces deux excès, une approche plus économe consiste à partir du cas d'usage. Un cas d'usage précis désigne un nombre limité de données, de systèmes et de personnes. Il permet de poser des questions concrètes : quelles tables, quel historique, quel responsable, quel taux d'erreur acceptable.
Les décisions prises pour ce premier cas d'usage deviennent les premiers éléments de la stratégie data. Elles ne remplacent pas une réflexion d'ensemble, mais elles lui fournissent une base observée plutôt que supposée.
Quatre décisions suffisent pour démarrer un premier cas d'usage sans s'exposer à un blocage prévisible. Elles s'enchaînent dans un ordre précis, car chacune dépend de la précédente : un seuil de qualité ne se fixe pas sans savoir à quoi servira la donnée, et un responsable ne se désigne pas sans savoir quelles données sont concernées.
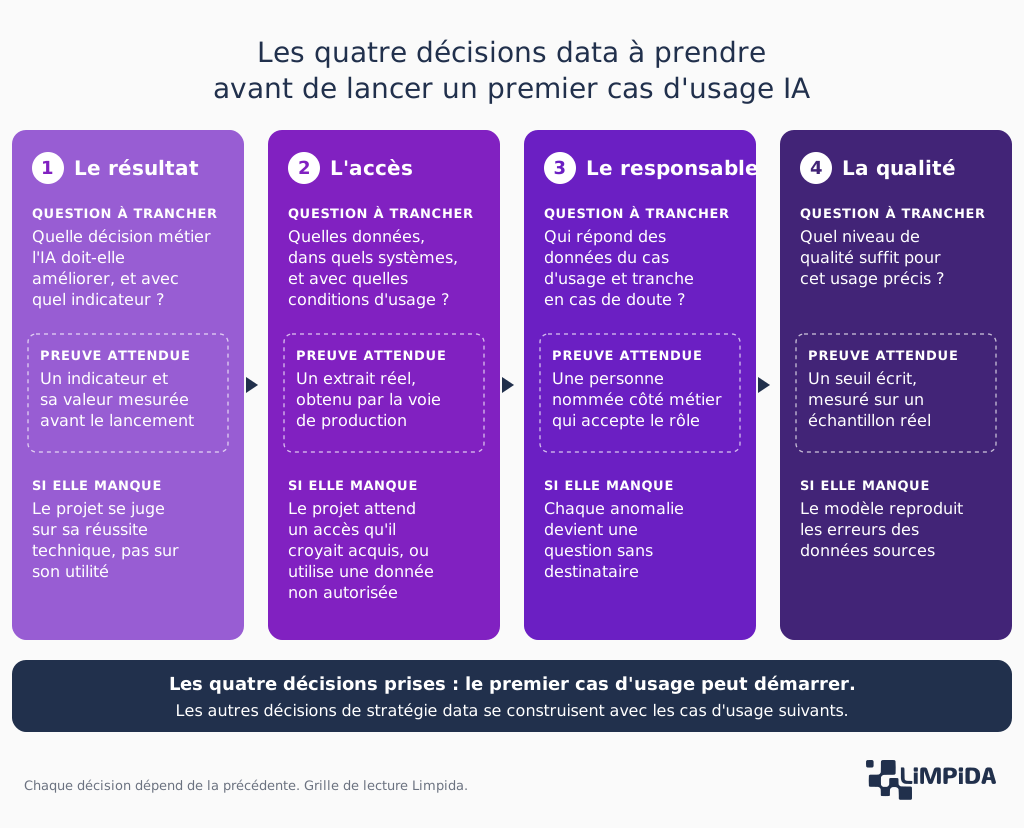
La première décision porte sur l'usage, pas sur les données. Elle consiste à nommer la décision ou le processus métier que l'IA doit améliorer, puis l'indicateur qui permettra de constater l'amélioration. Sans cet indicateur, le projet ne peut être jugé que sur sa réussite technique.
La valeur de départ de l'indicateur se mesure avant le lancement. Un gain annoncé sans point de comparaison ne se démontre pas, et le cas d'usage se défend alors sur des impressions. Cette décision oriente aussi le choix des données : une prévision des ventes et un assistant de réponse aux clients ne mobilisent ni les mêmes sources ni les mêmes exigences. Le choix du cas d'usage lui-même relève d'un exercice distinct, qui consiste à prioriser des cas d'usage IA sans sur-promettre.
La deuxième décision recense les données nécessaires et vérifie qu'elles sont réellement accessibles. Le recensement précise les systèmes sources, l'historique disponible, le format et la fréquence de mise à jour. La vérification consiste à obtenir un extrait réel, et non une description de ce que les systèmes sont censés contenir.
Les conditions d'usage se tranchent au même moment. Des données personnelles exigent une base légale et une information des personnes concernées au titre du RGPD. Des données issues d'un partenaire ou d'un fournisseur peuvent être soumises à des restrictions contractuelles. Un accès techniquement possible n'est pas un accès autorisé. Pour les assistants et les agents qui interrogent directement les systèmes de l'entreprise, la question de savoir quelles données ouvrir aux agents IA, et à quelles conditions se pose dès cette étape.
La troisième décision désigne une personne côté métier qui répond des données mobilisées : leur définition, leur qualité et leurs règles d'usage. Ce rôle correspond à celui de Data Owner dans la plupart des modèles de gouvernance. Il n'exige pas une organisation de gouvernance complète, seulement un nom et un engagement écrit.
Cette personne tranche lorsque deux sources se contredisent, valide les règles de correction et décide si une donnée peut servir à l'usage visé. Sans elle, chaque anomalie découverte par l'équipe projet devient une question sans destinataire. Les équipes techniques finissent alors par corriger elles-mêmes, avec des règles que le métier ne reconnaît pas.
La quatrième décision fixe un seuil de qualité adapté à l'usage, et non un idéal de qualité générale. Un assistant qui propose des réponses relues par un collaborateur tolère davantage d'imprécision qu'un système qui déclenche automatiquement une décision vis-à-vis d'un client. Le seuil porte sur quelques critères concrets : complétude des champs utilisés, cohérence entre les sources, fraîcheur des données.
Ce seuil se mesure sur un échantillon réel avant le lancement. Si l'écart est trop important, deux options existent : corriger les données sources ou réduire l'ambition du cas d'usage. Les deux options sont légitimes, à condition que le choix soit fait avant le développement et non découvert après. Les mécanismes par lesquels des données dégradées compromettent un projet sont détaillés dans l'analyse des raisons pour lesquelles la mauvaise qualité des données est le premier risque IA.
Pour certains systèmes, ce seuil ne relève pas seulement d'une décision interne. Le règlement européen sur l'intelligence artificielle impose que les systèmes d'IA à haut risque entraînés à partir de données reposent sur des jeux de données d'entraînement, de validation et de test soumis à des pratiques de gouvernance et de gestion des données, et conformes à des critères de qualité (règlement (UE) 2024/1689, article 10, EUR-Lex). La classification du cas d'usage fait donc partie des vérifications de la deuxième décision.
Les quatre décisions se vérifient en quelques semaines lorsqu'un sponsor est identifié et que les détenteurs des données sont disponibles. Le but n'est pas de produire un document de cadrage, mais d'obtenir des preuves : un extrait de données, un nom, une mesure.
Un premier atelier réunit le sponsor métier, un représentant de la DSI et l'équipe data ou le prestataire chargé du cas d'usage. Il fixe l'indicateur de résultat, liste les données supposées nécessaires et identifie le responsable pressenti. Une demi-journée suffit lorsque le cas d'usage est déjà choisi.
La présence de la DSI dès ce premier atelier évite une erreur fréquente. Les délais d'ouverture des accès aux systèmes sources peuvent dépasser la durée du développement lui-même. Les identifier tôt permet de lancer les demandes d'accès en parallèle des autres vérifications.
Les semaines suivantes servent à confronter les déclarations aux faits. L'extrait de données est obtenu par la voie qui sera utilisée en production, et non par une exportation manuelle. Le seuil de qualité est mesuré sur cet extrait. Le responsable désigné confirme son rôle par écrit auprès du sponsor.
À l'issue de cette vérification, chaque décision est soit prise, soit identifiée comme manquante, avec une action et une échéance. Un cas d'usage peut démarrer avec une décision en cours de traitement, jamais avec une décision ignorée.
Une part importante de la stratégie data n'est pas nécessaire au premier cas d'usage. Reporter ces décisions n'est pas un renoncement : elles gagnent à s'appuyer sur ce que les premiers cas d'usage auront appris à l'organisation. Le tableau suivant distingue, domaine par domaine, ce qui se décide avant le premier cas d'usage et ce qui peut attendre.
| Domaine de la stratégie data | À décider avant le premier cas d’usage | Peut attendre les cas d’usage suivants |
|---|---|---|
| Gouvernance des données | Une personne nommée côté métier répond des données du cas d'usage. | Le modèle de gouvernance d'ensemble, les comités et les rôles par domaine de données. |
| Qualité des données | Un seuil adapté à l'usage, mesuré sur les données réellement utilisées. | Le dispositif de mesure continue de la qualité sur l'ensemble des domaines. |
| Plateforme et architecture | Un accès fiable aux sources nécessaires, par la voie qui servira en production. | Le choix d'une plateforme cible ou d'une architecture commune à plusieurs cas d'usage. |
| Conformité | Les conditions d'usage vérifiées : base légale RGPD, contrats, niveau de risque du système d'IA. | L'inventaire complet des systèmes d'IA de l'entreprise et la politique générale d'usage de l'IA. |
| Organisation | Un sponsor métier et une équipe projet identifiés pour le cas d'usage. | Le dimensionnement d'un Data Office ou d'une équipe dédiée à l'IA. |
| Feuille de route | Le premier cas d'usage, son indicateur de résultat et sa valeur de départ. | La roadmap des cas d'usage et des chantiers de fondation sur douze à vingt-quatre mois. |
Le premier cas d'usage produit des informations qu'aucun travail préalable ne fournit : le temps réel d'obtention d'un accès, l'écart entre la qualité supposée et la qualité mesurée, la disponibilité effective des responsables métier. Ces informations rendent la stratégie data plus réaliste qu'un diagnostic fondé sur des déclarations.
Au deuxième ou au troisième cas d'usage, des besoins communs apparaissent : les mêmes sources reviennent, les mêmes défauts de qualité se répètent, les mêmes accès sont demandés. Les décisions d'ensemble (plateforme commune, gouvernance par domaine, référentiels partagés) deviennent alors justifiables, parce qu'elles servent plusieurs usages identifiés. Elles s'organisent dans une roadmap data construite en quelques semaines, qui séquence cas d'usage et chantiers de fondation.
Certaines situations justifient de reporter le lancement, même lorsque le sponsor est pressé. Quatre signaux indiquent qu'une décision data manque et que le cas d'usage risque d'échouer sur ce manque.
Reporter ne signifie pas abandonner. Le report porte sur la date de lancement, pas sur l'intérêt du cas d'usage. Une fois la décision manquante prise, le cas d'usage repart sur une base plus solide. Lorsqu'une expérimentation est déjà en cours, les mêmes critères servent à déterminer si un POC IA doit continuer ou s'arrêter.
Le passage du premier cas d'usage à une démarche durable repose sur une règle simple : chaque nouveau cas d'usage reprend les quatre décisions et réutilise celles qui ont déjà été prises. Le responsable désigné pour une source n'est pas désigné une seconde fois, le seuil de qualité mesuré sert de référence, l'accès obtenu reste disponible.
Au fil des cas d'usage, ces décisions forment un ensemble cohérent qui constitue progressivement la stratégie data de l'organisation. Le pilotage du portefeuille prend alors le relais, avec un cadre pour décider, prioriser et arrêter des cas d'usage Data & IA. Les règles propres à l'IA (usages autorisés, contrôle des résultats, responsabilités) s'ajoutent à ces décisions data sans les remplacer, et relèvent de la manière de gouverner l'IA en entreprise.
Un état des lieux périodique permet de mesurer le chemin parcouru. Une grille simple pour évaluer la maturité data indique quelles fondations restent à construire avant d'engager des cas d'usage plus ambitieux.
La stratégie data et l'IA ne se succèdent pas : elles progressent ensemble, cas d'usage après cas d'usage. Avant le premier, quatre décisions suffisent, et elles se vérifient sur des données réelles. Ces vérifications prennent quelques semaines et évitent des blocages qui surviennent sinon après plusieurs mois de développement.
Pour une organisation qui n'a encore lancé aucun cas d'usage, le point de départ est donc un cas d'usage précis et une fiche d'une page, plutôt qu'un programme de stratégie data de plusieurs mois ou une série de démonstrations sans suite.
Une stratégie data complète n'est pas un prérequis au premier cas d'usage IA. Quatre décisions data suffisent pour démarrer : le résultat attendu, l'accès aux données, un responsable de ces données et un seuil de qualité adapté à l'usage.
Quatre décisions, dans cet ordre, car chacune dépend de la précédente. Chacune se vérifie par une preuve concrète plutôt que par une déclaration.
Une personne côté métier, qui répond de la définition, de la qualité et des règles d'usage des données mobilisées. Ce rôle correspond à celui de Data Owner dans la plupart des modèles de gouvernance.
Le niveau requis dépend de l'usage, pas d'un idéal général. Un assistant dont les propositions sont relues par un collaborateur tolère davantage d'imprécision qu'un système qui décide automatiquement.
Quelques semaines suffisent pour vérifier les quatre décisions lorsqu'un sponsor est identifié et que les détenteurs des données sont disponibles. L'objectif est d'obtenir des preuves, pas un document de cadrage.
Les décisions d'ensemble peuvent attendre que plusieurs cas d'usage les justifient. Elles gagnent à s'appuyer sur ce que les premiers cas d'usage ont révélé.
Un cas d'usage se reporte lorsqu'une des quatre décisions manque sans plan pour la prendre. Le report porte sur la date de lancement, pas sur l'intérêt du cas d'usage.